阅读一个优秀的开源项目,很容易产生两种冲动:第一,看到它的功能名称就认为当前项目也需要;第二,看到 README 或 benchmark 数字就把它当成已经验证的能力。
真正困难的不是发现“别人做了什么”,而是回答另外几个问题:这个机制在固定版本里是否真的存在?它是否进入默认运行路径?它修改了哪种 Authority?失败时会留下什么?它适合由产品、公共平台还是 Agent Runtime 承担?把它带回来以后,我们能够证明的是机制成立,还是效果更好?
我对 MemoryBear、MindMemOS、Letta Code 等项目的研究逐渐收敛成一套方法。研究的输出不是功能愿望清单,而是固定证据、适用边界、拒绝理由和可以重新验证的候选合同。
第一步:先固定研究对象
“我研究了 MindMemOS”并不是一个可复查结论。开源项目的 main 会移动,README、默认配置和执行路径都会变化。没有 tag、commit 或 tree,今天的结论可能在几周后失去对象。
当前研究记录明确固定了不同来源:
- MemoryBear 使用官方仓库的
v0.4.2-hotfix,commit5897a2b2cba2a008678a309e19d8f83f8d9ed930; - MindMemOS 的稳定版本研究固定在
v0.1.5,commitb890b6af35a27aca643b4b1b49552f2cb72324c6; - 对 MindMemOS 后续 Dreaming、Graph Link 和 Schema 路径的补充研究,另行固定到当时的 current-main commit,并明确不把它回写成
v0.1.5的能力; - 官方 release note、论文和网站只作为相应级别的来源,不覆盖固定代码树。
现在访问 MemoryBear 官方仓库 或 MindMemOS 官方仓库,看到的可能已经是更晚版本。公开文章因此保留固定 commit,而不会用“最新版本”这种无法长期复核的说法。
第二步:给每条信息分级
不同来源回答的问题不同:
| 来源 | 可以支持什么 | 不能自动支持什么 |
|---|---|---|
| 官网或产品介绍 | 项目如何定位自己、面向哪些场景 | 真实实现、默认启用、稳定性和效果 |
| Release note | 某个版本宣称增加或修复了什么 | 修复路径完整、行为可复现、旧边界已经消失 |
| README / API 文档 | 使用方式、公开接口和推荐配置 | 内部副作用、错误恢复和默认运行链 |
| 固定源码 | 控制流、类型、存储写入和策略参数存在 | 路径已在真实环境运行、质量更好 |
| 上游测试 | 上游作者验证的案例 | 当前产品中的兼容性和效果迁移 |
| 本地受控验收 | 当前项目在明确环境下的真实路径 | 上游完整等价、生产运行和一般化质量 |
例如,MindMemOS 当前 README 将自己描述为可在 Agent 间复用和持续演进的 Memory 操作层,也展示 Memory add/search、feedback、dreaming 和 Skill evolve 等接口。这能够说明项目方向,却不能单独证明稳定 v0.1.5 已经实现自动在线 Schema 学习,更不能证明这些机制会提升 TraceWise 的回答质量。
同样,MemoryBear 的官方 release note 可以作为产品方向的佐证;其中的准确率或“生产级”表述若没有独立复现,就不会被带入 TraceWise 的能力声明。
第三步:追踪真实执行路径
源码中出现一个类或配置项,不代表它参与了系统运行。研究需要从触发入口一直追到状态和副作用:
触发条件
  → 输入窗口与身份
  → 候选生成
  → 风险或策略判断
  → Authority 写入
  → 失败与恢复
  → 后续 Runtime 是否真的消费结果
方法图:研究输出首先是证据和边界,不是待搬运的功能清单。
以 MemoryBear Reflection 为例,固定源码显示候选发现会组合名称和 alias、可选 embedding、低频扫描以及模型判定。继续向后检查会看到,上游 apply 可能更新描述、重定向 Neo4j 关系并删除 losing entity。候选发现和破坏性合并属于同一个产品的不同阶段;如果只读前半段,很容易把整条路径理解成“安全的实体去重”。
研究因此不能停在算法名称。它必须问:谁拥有 loser node?删除后能否恢复?Evidence 和原始身份是否仍能追踪?Runtime 后续读取的是新节点、旧节点还是别名 projection?
第四步:用最小反例攻击大结论
研究时先为机制结论寻找反例,确认它在什么输入、版本和运行条件下成立。
反例一:存在 save_to_file(),不等于自动 Schema 学习
MindMemOS 的实体管理代码存在注册、更新和保存 primitive。但在固定稳定版本的服务器运行路径中,研究没有找到非测试调用能够把抽取结果自动发布成新 Schema Authority。抽取又受已配置 entity types 约束。
因此正确结论是“存在 Schema 建模和保存能力”,而不是“系统已自动学习并持久化新 Schema”。如果要形成在线演进,还需要候选、独立验证、发布、迁移、激活和回滚的完整合同。
反例二:存在 reinforcement counter,不等于反馈策略完整
一个可变计数器不能回答:什么反馈可信、怎样绑定到具体 Memory 版本、如何影响排序、恶意或错误反馈怎样撤销、重放是否重复计数。
因此研究不会把一个字段直接变成“自学习闭环”。真正可采用的是包含来源、版本、评分规则、上限、冲突和修正的完整策略。
反例三:存在 ACT-R 公式,不等于当前生产路径正在执行遗忘
MemoryBear 固定源码中能够找到 activation 计算、历史遗忘策略和当前 capacity-triggered soft deletion。但研究同时发现旧 scheduler 已被注释或弃用,历史摘要路径包含物理删除,而当前 operational path 与旧 ACT-R 链并不是一条已经证明持续运行的完整线路。
因此只能分别描述这些机制,不能把它们拼成“当前系统自动执行 ACT-R → 摘要 → 可恢复遗忘”的更强故事。
第五步:先做所有权映射,再谈采用
参考机制经常跨越产品和平台边界。把它搬回当前项目之前,需要先判断谁拥有:
- 业务 Graph 和 Evidence;
- Memory formation、recall 和 lifecycle;
- 背景任务调度、Worker、重试和取消;
- Schema 的发布和迁移;
- Host Model、Prompt 和用户审核;
- 生产身份、权限和运维。
TraceWise 拥有产品 Project、Graph、Evidence、Reviewer、Prompt、Host Model 和业务体验;Agent Foundation 只通过 agent_foundation.public.* 提供公共治理和 Authority 合同;外部 Agent Runtime 承担调度、并发、取消和 Worker 生命周期。
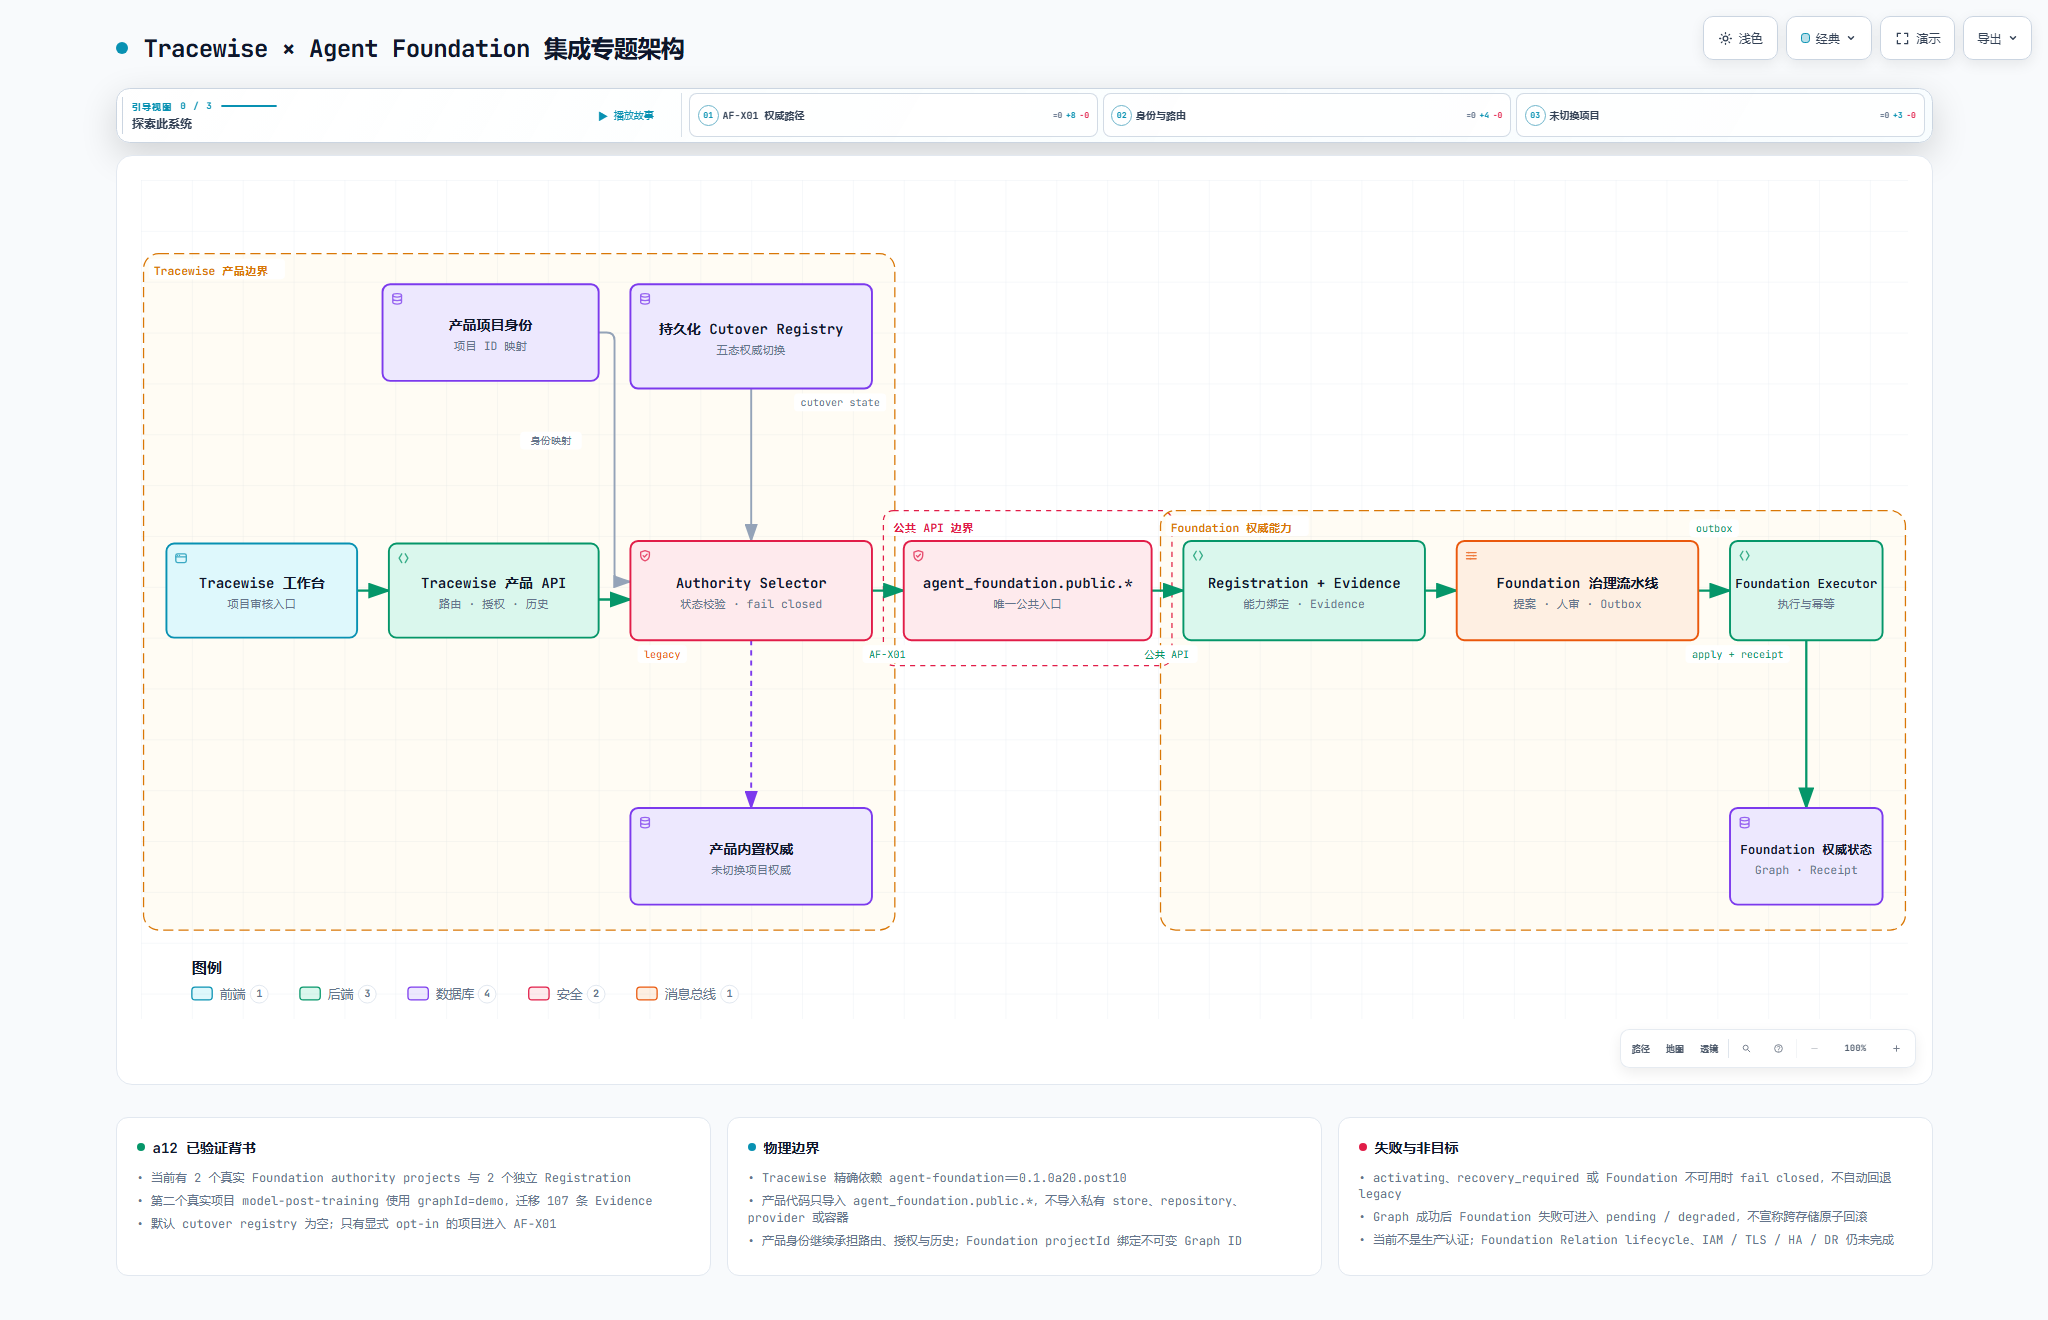
技术解释图:参考机制只有在所有权清楚后,才可能进入产品或平台。图不表示 MemoryBear 或 MindMemOS 被部署。
这个映射阻止了几个常见错误:
- 因为 Memory 项目存在 Graph,就让 Memory Core 获得 TraceWise 产品 Graph 的写权;
- 因为上游有后台 Dreaming,就把调度器塞进 Memory Core;
- 因为模型能规划 mutation,就让它直接 publish Schema;
- 因为平台有公共能力,就把产品 Reviewer 和 Prompt 归因给平台。
第六步:只采用完整、最小、可验证的合同
研究后的决策不只有“采用”和“不采用”,至少包含三种结果:
- 有界采用:机制解决了真实缺口,所有权清楚,并能形成独立验收;
- 保留研究:机制存在,但当前场景、质量或运行证据不足;
- 明确拒绝:破坏 Authority、依赖错误边界,或只是重复已有能力。
MemoryBear:采用候选发现思想,拒绝破坏性复制
MemoryBear 的实体候选发现和 Reflection 提供了有价值的机制来源。但本地适配没有复制 losing node 的物理删除,也没有把产品 Graph 写入交给 Memory Core。
有界做法是:在同一 Scope 内发现候选,形成零写 risk plan;低风险、证据充分的 exact alias 可以进入 source-preserving successor,源 Memory 保持可追踪;敏感身份、语义冲突和跨 Scope 情况要求 owner decision 或直接 blocked。后续 Runtime 只消费当前 active authority。
这证明本地机制按自己的合同运行,不证明完整复现 MemoryBear,也不证明 answer quality 提升。
MindMemOS:吸收结构化维护思路,不复制无界模型写入
MindMemOS 的稳定版和固定 current-main 研究显示了 structured Dreaming、create/update/merge/archive/link、lineage、Schema dual-path retrieval 等有价值方向。但 upstream executor 与 Agent Foundation 的 Registration、Policy、rollback 和 product Graph ownership 并不相同。
有界适配因此冻结输入窗口,要求 typed action,保留 source lineage,并由 Policy 约束 create/update/merge/archive/link。低风险、可恢复的 Memory 操作可以按完整 Variant 执行;Graph 变更保持产品控制;Provider 缺失时报告 optional-route degradation;模型质量继续未验证。
Letta Code:识别背景维护生命周期,而不是复制文件结构
Letta Code 的固定源码和官方文档提供了另一种有价值模式:按 step count 或 compaction event 触发背景 reflection,使用不可变消息游标,成功后推进状态,并保留版本历史。
真正值得吸收的是“固定输入窗口—后台维护—形成新版本—后续 Runtime 消费”的生命周期,而不是某一种文件格式。定时器和后台 Agent 属于采用方 Runtime,不应为了复用 Memory 策略而进入 Memory Core。
为什么有些研究最后没有变成功能
一次研究得到 not_opened_no_qualifying_gap 不是失败。如果当前平台已经有更完整、更安全的合同,或者上游增量只是多个无法独立组合的旋钮,就不应为了证明“研究有产出”而新增 Profile。
典型保留项包括:
- 未经独立评估的模型质量和 benchmark 转移;
- 自动在线 Schema 激活;
- 任意 Graph/Cypher mutation;
- 跨 Scope 实体合并;
- 不可恢复的物理删除;
- 把 Skill evolution 混入 Memory Core;
- 仅凭 Provider binding 推断策略可组合。
研究的价值有时就是证明“当前不应该做”。这个结果减少了重复实现和错误所有权,也让未来重新评估时有明确条件。
怎样避免网络内容污染项目事实
网络资料可以提供概念、比较对象和当前公开方向,但它必须与本地证据分栏:
| 内容 | 文章中的表达方式 |
|---|---|
| 上游官网定位 | “项目官方将其描述为……” |
| 固定源码观察 | “在 commit X 的具体路径中可以确认……” |
| 上游 benchmark | “官方报告”,除非独立复现,不写成事实转移 |
| 本地有界适配 | 只引用当前项目的实现、测试和 acceptance |
| 推断 | 明确写成判断,并列出可能推翻它的证据 |
NIST AI RMF 对第三方软件和数据风险也要求明确流程与 contingency。这提醒依赖评审需要记录版本、失败处置和责任方;标准符合性评估则是另一个尚未开展的工作。
研究结论需要经受哪些质疑
研究最终吸收了什么?
研究先固定版本和代码路径,再把机制拆成候选发现、Authority 写入、恢复和 Runtime 消费。只有所有权清楚、风险可控且能独立验证的最小合同才会被本地实现;破坏性删除、无界模型写入和未经复现的效果不会迁移。
为什么不直接安装 MemoryBear 或 MindMemOS?
因为它们是完整产品,拥有自己的数据模型、服务依赖和运行假设。TraceWise 需要的是少数机制的设计参照,不是把另一个产品变成内部依赖。当前 TraceWise 的正式依赖仍是精确版本的 Agent Foundation 公共包。
怎样避免研究停留在 README?
研究记录包含 tag、commit、tree、具体源码路径、最小反例和 gap ledger,并区分 official-source-confirmed、code-confirmed 与 locally verified。对外部服务没有完成运行验证的地方,会明确写出。
这些研究提高了模型效果吗?
当前没有证据支持这个结论。已验证的是本地 Authority、lineage、fallback 和 Runtime consumption 机制;模型质量、长期记忆效果和 benchmark transfer 需要独立数据集、baseline 和 evaluator。
结语
好的研究不是把别人的功能名称搬进路线图,而是让当前项目更准确地知道:哪里真的有缺口,哪条机制能够填补,谁拥有它,什么副作用不能接受,以及需要什么证据才能改变决定。
MemoryBear、MindMemOS 和 Letta Code 为 TraceWise/Agent Foundation 提供了重要参照,但它们没有因为被研究就成为运行依赖,也没有把未经复现的效果转移给当前项目。
研究最终形成的不是“我们也有”,而是四类更可复查的结果:已采用的有界合同、仍保留的候选、明确拒绝的路径,以及能够触发下一次重审的新证据条件。