AI 项目很容易陷入一种“功能正确、产品错误”的状态:模型能对话、Graph 能展示、Agent 有多个名字、测试数字不断增加,但用户仍然不知道该相信哪条结论、下一步该做什么,也无法在依据改变后解释旧决定。
这也是我在 TraceWise 中逐渐形成的判断标准:一个功能值不值得做,不取决于它能否出现在演示清单里,而取决于它是否改善了一项真实决策,并且这种改善能否被观察、验证和追溯。
Martin Fowler 在 Outcome Over Output 中区分了产出和结果:发布多少功能属于 output,软件是否帮助使用者完成目标才接近 outcome。TraceWise 尚未完成正式商业用户研究,因此先把具体任务作为设计与开发评测的对象:每个功能都需要说明,它试图改善哪一步判断。
TraceWise 用户真正要完成的工作
TraceWise 面向的不是“想找一段日志的人”,而是需要调查复杂项目状态的人。面对一个失败、风险或历史争议,用户真正要完成的是四项工作:
- 找到与当前问题相关的项目事实,而不是得到一堆相似文本;
- 看清结论引用了哪些 Evidence、哪一版实体和哪条规则;
- 决定是否接受 AI 提出的变更,并留下责任明确的理由;
- 在状态变化后恢复历史结果,知道它当时为何成立、现在为何可能失效。
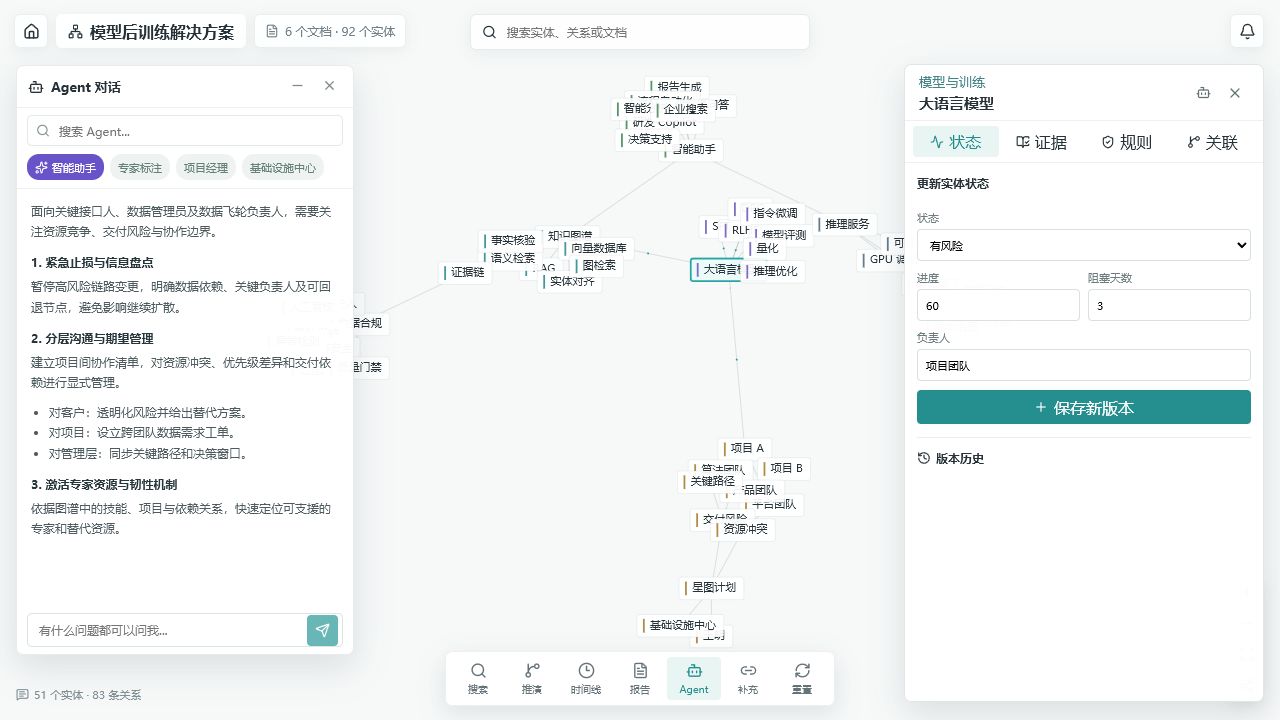
真实产品截图:页面围绕项目调查组织,而不是围绕模型参数组织。画面使用合成项目数据,只证明该界面状态被实际渲染。
如果某项候选能力不能进入这四步中的任何一步,就需要非常谨慎。它可能是底层优化,也可能只是增加演示效果;只有前者能通过明确指标或风险下降得到解释。
我使用的功能判断框架
我最终把功能判断收敛为五个连续问题。
一、它改变了哪一个用户决定
“支持知识图谱”“接入模型”“增加 Persona”都不是用户结果。更有效的问题是:
- 用户原本要怎样完成判断;
- 哪一步最慢、最不确定或最容易出错;
- 新能力让哪一步变得更清楚;
- 如果不实现它,用户是否仍能完成闭环。
例如,多信号检索的价值不是“搜索算法更多”,而是减少用户逐条拼接项目材料的成本,并让回答能够展示相关实体、关系和 Evidence。ReviewDecision 的价值不是“增加审批页”,而是阻止一个未经当前证据授权的模型建议直接改变 Graph。
二、它触碰了哪一种权威
AI 功能的风险常常不来自生成文本,而来自生成结果随后被怎样使用。
- 只读回答:可以展示,但仍要说明来源和不确定性;
- 生成 Proposal:必须通过 schema 和业务边界校验;
- 修改 Graph:需要当前 Evidence、Graph baseline 和 Reviewer 决定;
- 修改 Foundation Memory:还要满足 Foundation 自己的 Registration、Scope 和资源状态;
- 修改生产配置、权限或安全策略:当前 TraceWise 没有因此获得生产控制权。
候选功能越接近不可逆写入,所需证据、审核和恢复机制就越强。这个规则比“凡是 AI 都加人工确认”更精确,因为它让控制成本与真实副作用相匹配。
三、成功和失败能否被准确表示
如果功能只能表达成功,不能表达部分成功、过期、降级和待恢复,它通常还没有形成可靠的产品合同。
TraceWise 的几个重要决定都来自这个问题:
- Graph 已成功、Foundation 失败时,状态是
applied_with_foundation_pending,不是整体成功,也不是虚构回滚; - 核心知识副本遗漏 Simulation、Agent 交互和报告时,产品明确列出 omitted sections,不把它叫完整备份;
- Evidence 或 Graph 在审核后发生漂移时,旧 ReviewDecision 变成 stale,而不是继续批准新内容;
- Foundation Graph authority 不可用时,已切换项目返回 typed failure,不悄悄写回 legacy。
失败语义不是开发细节。它决定用户能否知道当前状态,以及下一步应该重试、重新审核还是停止。
四、有没有更小的方案
每个候选能力都要与更小方案比较:
| 候选方向 | 更小方案 | 最终判断 |
|---|---|---|
| 不受限的自主 Multi-Agent | 按任务限制分支、工具与预算 | 早期使用串行责任流水线;后续有界单/双分支调查作为开发实现,增加分支仍需任务收益证据 |
| 通用跨存储事务框架 | 记录部分成功并对原决定幂等重试 | 写入边界不同,分别保存已完成部分和 pending/retry 状态 |
| 完整项目备份恢复 | 隔离的核心知识副本 | 当前数据合同只覆盖 Entity、Relation、Evidence 和 Rule,因此缩小产品承诺 |
| 全量 Foundation 切换 | 项目级显式 opt-in | 先用两个受控本地项目验证身份、迁移和回退边界,不做全局开关 |
| 所有搜索统一换成向量 | 按正文、实体与关系分别评价 | 正文保留重排候选,节点多信号默认不变,关系按有向引用单独核对 |
更小方案并不意味着降低质量。它的意义是只为已出现的风险付出复杂度,不提前购买一整套尚无使用场景的抽象。
五、什么证据出现后可以停止
没有停止条件的项目会不断制造“下一批”。TraceWise 的一个交付切片只有在以下条件同时满足时才结束:
- 约定的用户工作流可以完成;
- 最小反例已经从失败变为通过;
- 关键相邻负例失败关闭;
- 对应 Authority 的真实状态被检查,而不是只看 HTTP 200;
- 未完成范围被写入当前状态和路线图;
- 交付物能够从明确版本和证据重新定位。
生产流量、HA/DR、租户安全或模型质量如果不属于当前目标,就不能因为“还有时间”而偷偷加入验收,也不能反过来把它们写成已经完成。
把功能放进决策链,而不是堆在首页
TraceWise 的完整路径是:项目与 Graph 定位、上下文检索、带 Evidence 的解释、结构化 Proposal、人审、受控执行、历史和报告。一个功能只有接入其中某个权威节点,并拥有相应失败语义,才算进入产品。
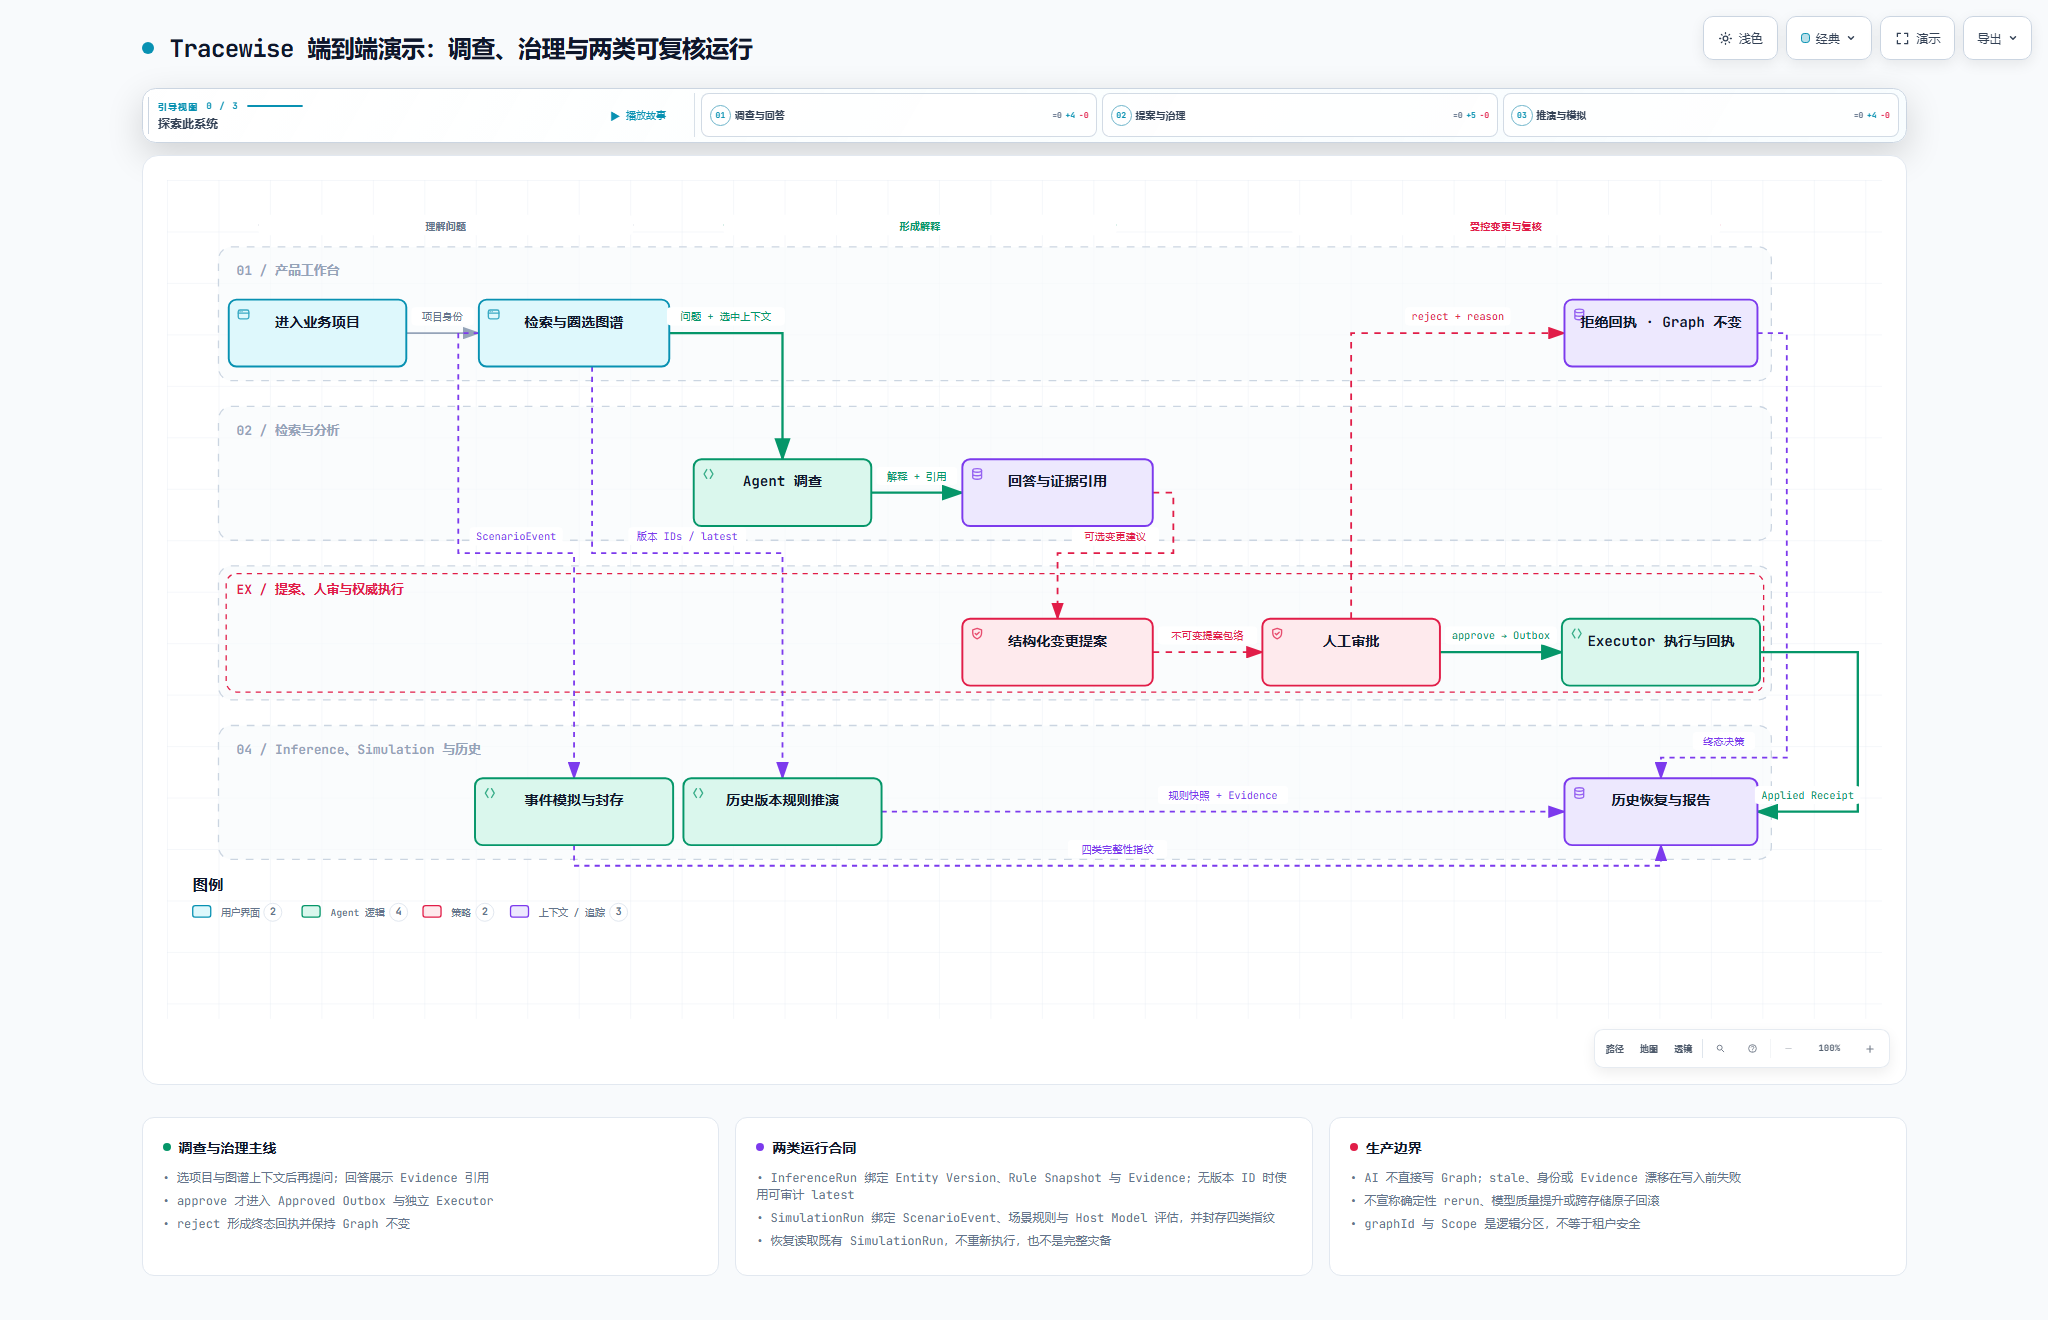
技术解释图:有价值的功能必须进入一条可验证的用户决策链。图用于说明关系,不是运行证据。
这套路径也解释了为什么某些技术能力没有被做成视觉中心。例如 Foundation 很重要,但用户并不需要在每次调查中理解平台内部 Registry、Provider 或存储实现;这些能力应该通过稳定公共契约支持产品,而不是占据主要操作流程。
四个真实取舍
取舍一:先解决“依据是什么”,再追求回答更像人
早期最容易继续优化的是 Prompt、Persona 和回答语气。但最小反例表明,Persona 并不控制子图选择,Verifier 的 confidence 也不是经过校准的正确率。继续装饰角色只会放大误解。
因此优先级转向 Context 来源、Evidence 引用、Graph 邻域和输出 schema。这个选择没有证明模型质量更高,却提高了结论可审阅性。
取舍二:把批准建模为证据合同,而不是布尔值
增加一个“批准”按钮很容易,困难的是说明它批准了什么。TraceWise 将决定绑定 Proposal fingerprint、Graph revision、Evidence fingerprint、Policy、Reviewer、Project 和 Scope。它增加了模型和验证成本,但换来了一个明确结果:审核后的依据发生变化,旧批准不能继续授权。
取舍三:恢复历史,不承诺重现模型
云端 Host Model 可能变化,当前规则和 Evidence 也可能变化。与其宣称确定性重跑,TraceWise 先保证已完成 SimulationRun 的 input、timeline、output 和 fingerprints 可以按 run_id 恢复;显式历史实体版本必须真实驱动规则计算。
这解决的是“当时发生了什么”,不是“未来再调用一次一定生成同样文本”。
取舍四:第二个项目优先于第三套抽象
一个项目跑通可能依赖偶然身份。第二个真实项目暴露了 product project ID 与 Graph authority project ID 被混用的问题。修复后,model-post-training 使用独立 Registration,迁移 107 条 Evidence,并能从正式 wheel 重新打开;第一个 Pilot 和未 opt-in 项目保持原状态。
这个结果比继续增加抽象层更有价值,因为它直接攻击了“只对 demo 成立”的风险。但它仍是受控本地采用,不是组织级迁移或生产证明。
新的取舍:同样叫“搜索”,采用决定却不同
正文搜索通常要找齐回答所需的材料,实体搜索可能要定位一个具体对象,关系查询还要保留方向与来源。这些动作都叫搜索,却不能用一个总分替代用户目标。
在 2026 年 9 月 10 日使用 Foundation post22 的开发对照中,同一 30 候选、最终 10 条和 8000 字符预算下,正文检索完整保留已声明必要依据的题数从 51/71 提升到 60/71。收益支持保留重排增强候选,但其中工作流题仍只有 7/13 完整;面向流程调查时,不能只用总分决定采用。
节点对照提供了另一种信号。语义模式让 10 道单目标题的首位命中从 4 道升到 5 道,但在 12 道实体题中,完整找到所需实体组的数量从多信号的 11 道降到 10 道。于是节点保留多信号默认,语义作为显式选项。结果来自 AI 编写、复核且已暴露的开发材料,不是独立用户验收或答案正确率;这些配置也尚未成为正式发布的统一默认。
这个决定体现了三个产品问题。第一,采用前先定义什么叫完成:找到一个答案、找齐多个条件,还是看见一条有方向的关系。第二,局部收益需要和退化一起看:一个目标提前了,另一个目标退出前十,不能相互抵消后就忽略。第三,默认策略影响所有走该入口的人,证据要求通常高于保留一个可选择的实验模式。
技术组件因此有不同命运:有收益的增强先留下,未全面胜出的替换不强推,还没找到证据的假设继续保持开放。下一次独立材料如果显示目标场景的稳定改善,就可以重新讨论默认配置。
How Much:成本应该落到具体动作上
证据化设计会增加工程成本:不可变信封、fingerprint、typed error、receipt、负例和状态维护都需要实现。成本还取决于检查时机:同样的依赖关系,如果每次读取都重新计算,可能让查询变慢;如果预先维护,就要承担准备、更新与失效处理的成本。
图读取实验在一次固定顺序的本地对照中,将 649 个对象的节点服务耗时从 77.578 秒降至 0.281 秒,同时单独记录首次准备 40.610 秒。这说明计算可以迁移到更适合的时点,但当前仍采用有界重建,不能据此推导任意规模和并发下的代价。
这些投入换来的不是已经量化的商业 ROI。当前能够确认的是:
- 历史版本错误、Snapshot 假绿和跨存储回滚错觉有可复现反例;
- 修复后有 focused regression、结构化 acceptance、真实存储读取或浏览器证据;
- 两个受控本地 Authority 项目证明了项目级选择,而非全局切换;
- 未验证的生产流量、HA/DR、tenant security 和模型质量仍然单独列出。
当前有本地读取耗时与开发题依据覆盖的对照,但尚无用户完成调查的时间、收入或正确决策比例的独立观测。工程指标接近目标的一部分,仍不能替代真实使用中的结果。
用 5W2H 做一次功能审稿
5W2H 的价值不在于背七个英文词,而在于防止方案只回答“怎么实现”。我把它转化成一张功能审稿表:
| 维度 | TraceWise 的审稿问题 |
|---|---|
| Why | 它改善哪项用户判断?为什么现有流程不够? |
| What | 最小可交付合同是什么?明确不包含什么? |
| Who | 谁使用、谁审核、谁拥有 Authority、谁承担错误风险? |
| Where | 在哪个 Project、Graph、Scope、环境和依赖版本成立? |
| When | 何时触发、何时过期、何时复审、何时停止? |
| How | 输入、验证、写入、失败和恢复路径是什么? |
| How Much | 增加多少复杂度?降低什么风险?哪些收益尚未量化? |
如果一个功能只能回答 How,却回答不了 Why、Who 和 How Much,它通常还不适合进入当前产品。
三个仍需回答的产品问题
这些判断怎样避免成为事后解释?
PROJECT_STATUS、ROADMAP、ADR、结构化 acceptance 和被保留的 superseded evidence 共同记录了决策如何形成和变化。关键不是证明每次选择都正确,而是让决策、反例、修复和边界形成可复查链路。
为什么不直接做更强的 Multi-Agent?
后续开发实现已包含有界单/双分支调查、只读工具、预算、取消和保存结果重开,但这不等于应继续增加分支。第三个 Agent 要解决哪种遗漏、增加多少调用、怎样检查输出,仍需按具体任务回答;分支数本身不是用户结果。
现有证据能否说明业务收益?
当前没有正式商业用户研究和 ROI 数据。现有材料只能证明本地产品流程、受控采用和若干失败修复;若要评价业务收益,需要代表性用户、基线任务、时间或错误成本指标以及独立观测。
结语
功能选择不是“技术上能不能做”的同义词。它至少包含用户结果、权威风险、失败语义、替代方案、验证成本和停止条件。
对 TraceWise 而言,检索策略要服务于找齐依据,治理机制要帮助用户判断现在还能用什么,性能优化要让这些检查的成本可承担。每一项采用决定都可以从这些任务重新检验,而不必从已经投入多少开发工作来倒推价值。