返回 TraceWise 项目总览 · 交互图:产品 · 运行时 · 架构 / 证据 · RUN · 血缘 / 端到端 · 工作流
假设一个项目实体昨天的状态是 at-risk,今天已经更新为 on-track。现在用户打开昨天的分析,界面上也显示“使用旧版本”。这个结果能不能被称为历史推演?
不一定。
如果系统只保存了旧版本 ID,却在计算时读取最新状态,那么它展示的是昨天的标签,执行的却是今天的事实。只看运行记录,一切似乎都可追溯;真正检查规则输入,历史已经被当前状态悄悄改写。
TraceWise 曾经就存在这个缺陷。修复前的最小反例里,调用方明确选择了旧版本 status=at-risk,运行记录也保存了那个 version ID,但规则实际读取的是最新版本 status=on-track。结果不是“历史高风险”,而是“当前无命中”。同一轮审计还发现:不存在、重复、跨 Graph 或属于错误实体的 version ID 没有全部失败关闭;一个重新构造的 SimulationService 无法从 SQLite 恢复已保存运行;API 也没有把 restore 和 rerun 的语义说清楚。
这篇文章回答一个问题:当项目事实、规则或模型都可能变化时,怎样证明一次历史分析真正使用了当时选择的输入,并在未来只恢复既有结果,而不是偷偷重新执行?
当前正式产品版本是 tracewise-product==0.2.0a12。本文讨论的历史版本与 Simulation restore 能力来自这条正式版本线中已经版本化、持续保留的能力切片,不把它扩大为 deterministic rerun、完整备份或灾难恢复。
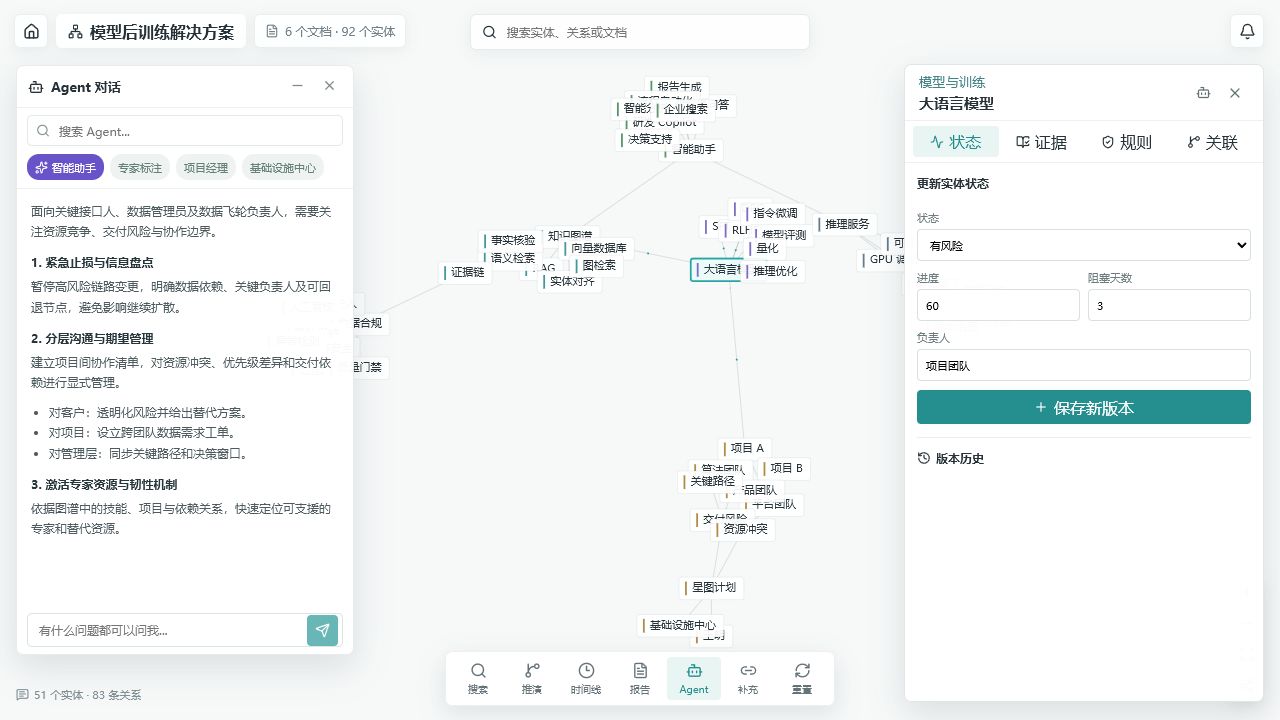
真实产品截图:工作台把 Graph 调查与实体状态版本放在同一产品界面。画面为合成项目数据,只证明该界面状态被实际渲染;历史计算是否可信仍需后端证据。
“可追溯”最容易出现的假象
很多系统会保存 request、timestamp、model name 和一段结果文本,于是把它称为“可重现”。但真正决定结果的输入通常比这些字段多:
- 某个实体的具体状态版本,而不是实体当前状态;
- 当时启用的规则及其版本;
- 参与判断的 Evidence;
- ScenarioEvent 和场景规则;
- Host Model 给出的那一次评估;
- 执行过程中形成的 timeline;
- 这些内容是否在保存后被篡改。
只保存“选择了版本 v1”并不够。必须证明 v1 的 state 真正进入规则计算;只保存最终输出也不够,因为无法判断 timeline 或输入是否后来变化;只保留一个“重新运行”按钮更危险,因为当前规则、当前模型和当前项目状态都可能与原运行不同。
TraceWise 因而把两个相关但不同的合同分开:
InferenceRun负责记录一次基于实体版本、规则快照与 Evidence 的推理;SimulationRun负责保存一次事件模拟的 input、timeline、output 和完整性指纹,并在未来按run_id恢复。
它们都和历史有关,却不是同一种“回放”。
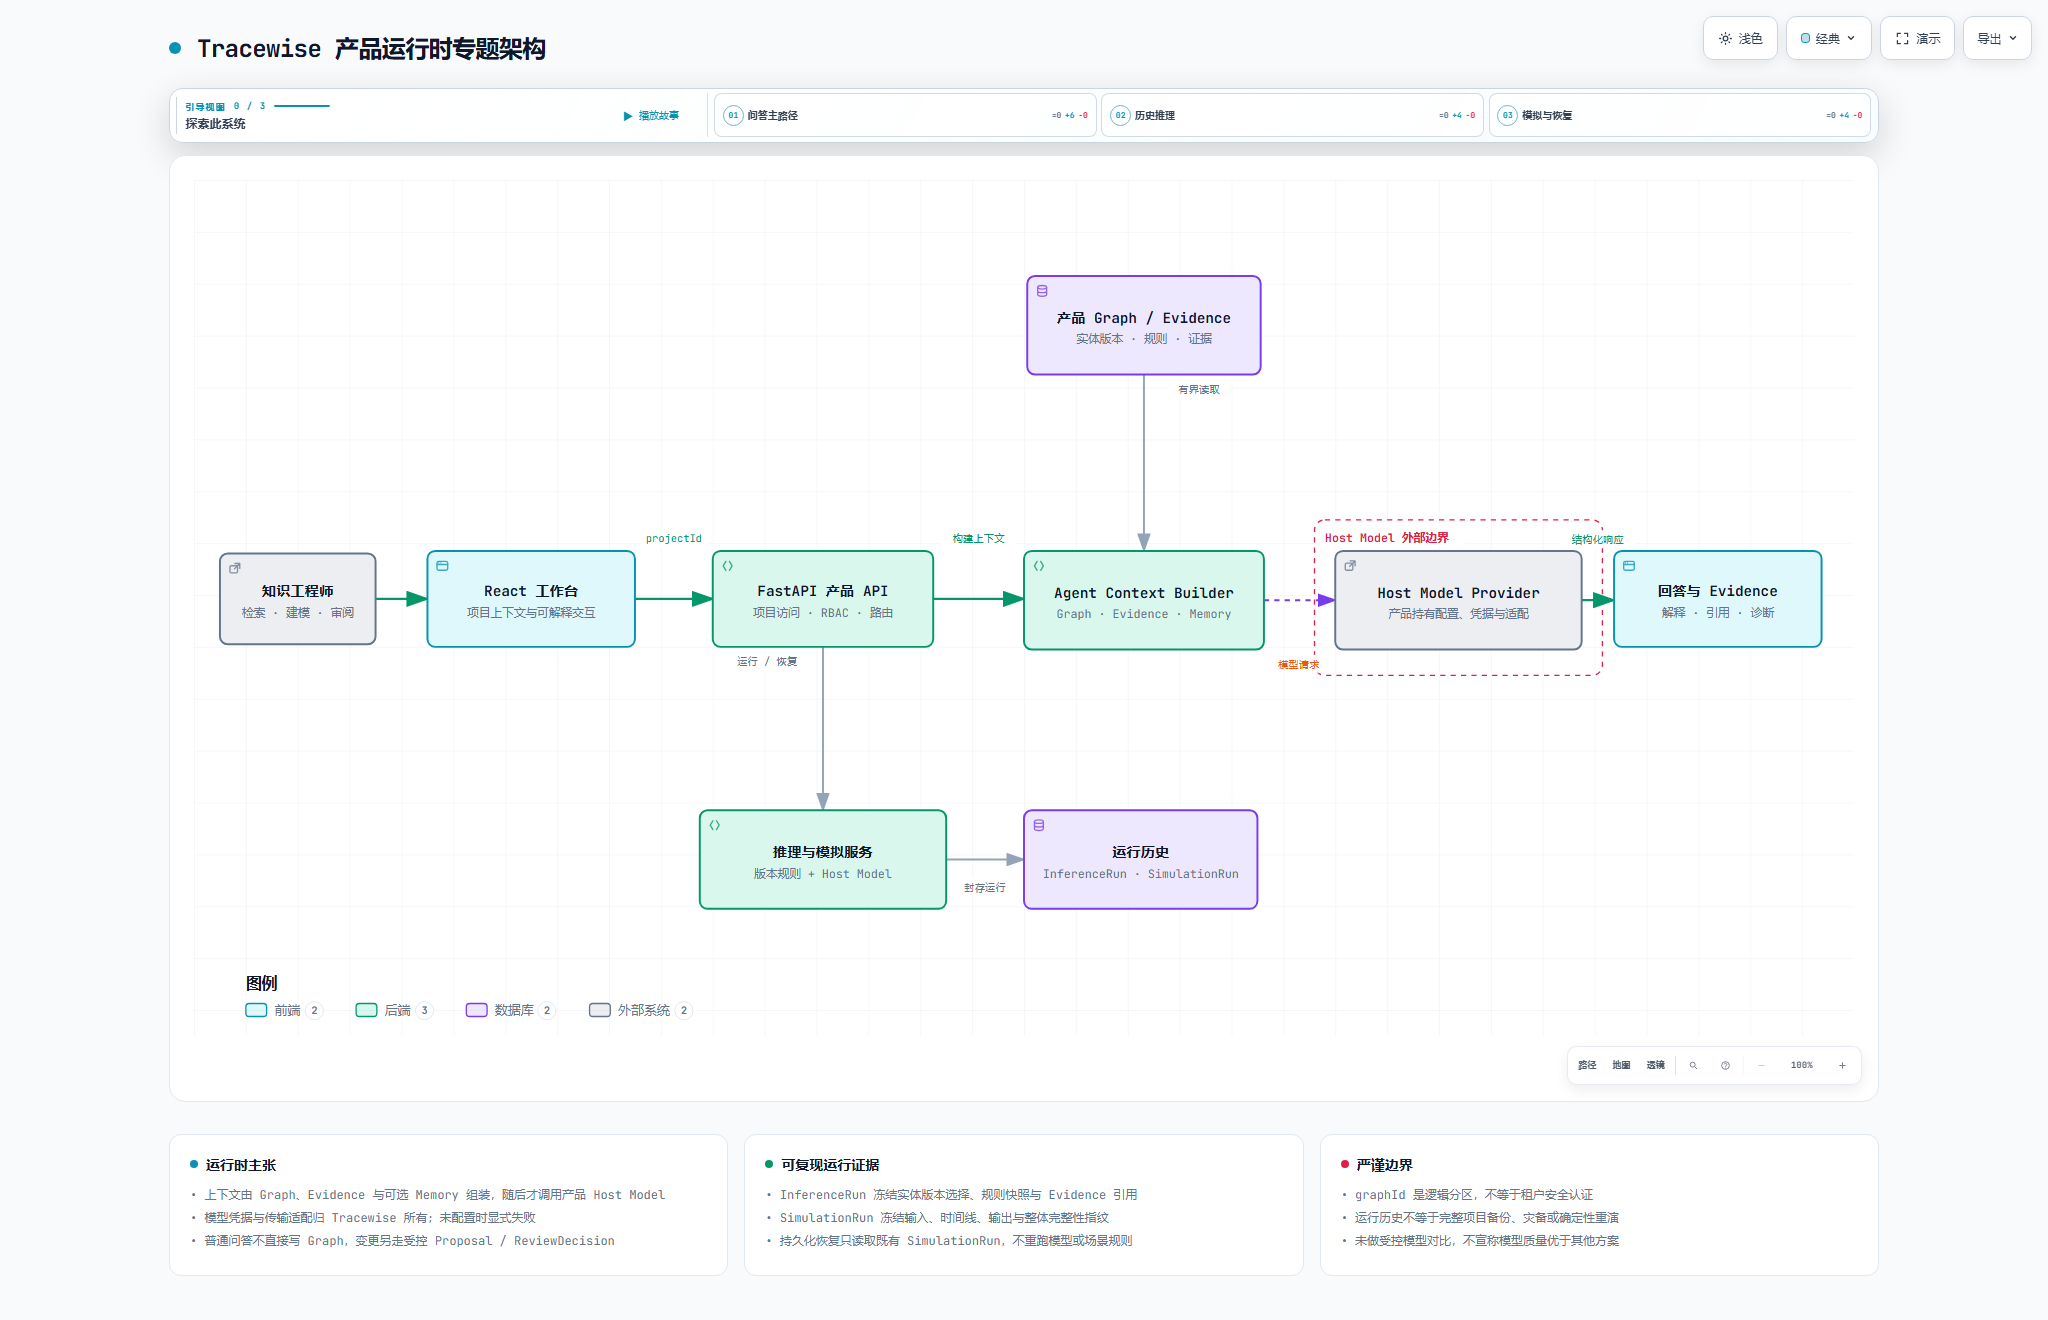
技术解释图:Inference 与 Simulation 读取产品 Graph/Evidence 和 Host Model,完成后进入独立运行历史;恢复路径只读取既有运行。
修复前:版本 ID 被记录,最新状态却驱动了规则
最小反例只需要一个实体和两个版本:
- v1:
status=at-risk - v2:
status=on-track - 规则:当
status equals at-risk时命中高风险
用户明确选择 v1。期望行为是规则读取 v1 的 state,产生一条高风险命中;实际行为却是运行记录保存 v1 ID,计算阶段读取最新版本 v2,因此没有命中。
这类缺陷比“没保存版本号”更危险,因为它制造了一条看似完整的审计记录。审计或验收时,如果只确认数据库里存在 entity_version_id 字段,就会得到一个假阳性:字段存在不等于它驱动了计算。
这一缺陷违反的最早不变量是:
运行记录中声称使用的实体版本,必须与规则计算实际读取的实体版本完全一致。
因此修复不应该停在界面、文案或补一个日志字段,而应从 InferenceService 的版本解析入口开始:先把 version ID 解析成受约束的持久化状态对象,再让规则只消费这组已经解析的版本。
两种版本选择模式必须显式且可审计
POST /api/inferences 现在有两种明确模式。
explicit:调用方指定精确历史版本
当 entity_version_ids 非空时,服务不会读取 latest 后再保存这些 ID,而是逐个从 TraceWise SQLite authority 解析版本,并校验:
- version ID 必须存在;
- version 所属
graph_id必须与本次运行一致; - version 必须一一对应请求中的
entity_ids; - version ID 不能重复;
- entity ID 也不能重复;
- 每个请求实体必须恰好解析到一个版本。
校验完成后,规则直接读取解析结果中的 version.state。v1 即使已经被 v2 取代,仍然以 at-risk 参与计算。
latest:调用方没有指定版本
当 entity_version_ids 为空时,服务为每个实体解析当前 latest;但这不是无痕默认。运行会保存 entity_version_selection_mode=latest,同时冻结实际解析到的 version IDs。
这两个字段解决了不同问题:mode 说明用户选择的是“精确历史版本”还是“运行时最新版本”,resolved IDs 则说明那个时刻的 latest 究竟是哪一版。以后即使又出现 v3,旧运行也不会只剩一句含混的“当时用的是最新”。
早期记录如果没有选择模式,会保持 legacy_unspecified。系统无法从缺失字段还原当时的选择,因此不回填 explicit 或 latest。
失败关闭比“尽量算出结果”更重要
历史推演中的错误输入不能自动降级到 latest。否则一个拼错的 version ID、跨 Graph 的 version 或属于另一个实体的 version,都可能被系统悄悄替换成当前状态,最终输出仍然是 201 success,却失去历史意义。
TraceWise 为这些情况保留 typed 422:
entity_version_not_foundduplicate_entity_version_identity_version_graph_mismatchentity_version_entity_mismatchlatest_entity_version_not_found
错误码的价值不是让接口更“规范”,而是让调用方知道为什么这次计算没有发生。不存在的历史状态不能通过 fallback 被发明出来;跨 Graph 的版本也不能因为字段结构相同就进入当前运行。
graph_id 在这里用于逻辑范围校验,它不是企业级租户安全认证。生产环境仍需要可信身份、项目授权、tenant/RBAC、资源所有权和水平越权测试。版本失败关闭只解决计算输入的一致性,不替代完整安全边界。
一次 InferenceRun 到底冻结了什么
版本选择只是第一层。完成一次 Inference 时,TraceWise 还保存:
entity_version_selection_mode- 已解析的
entity_version_ids RuleSnapshot:规则 ID、名称、版本和表达式- Evidence 引用
- 执行步骤与每一步的 Evidence IDs
- 规则命中、实际值、期望值和风险等级
- 最终 output 与完成时间
这样一条运行记录能回答:“哪个状态触发了哪条规则,规则当时是什么版本,哪些 Evidence 被绑定,为什么产生这个风险结论。”
但它仍不是通用 deterministic rerun 合同。冻结输入和输出,可以解释已经发生的运行;若要保证未来在不同代码、依赖、浮点环境或模型版本下重新执行仍得到相同结果,还需要冻结执行器版本、依赖、模型 revision、随机性和更多环境信息。当前项目没有把这一更强主张混进历史恢复。
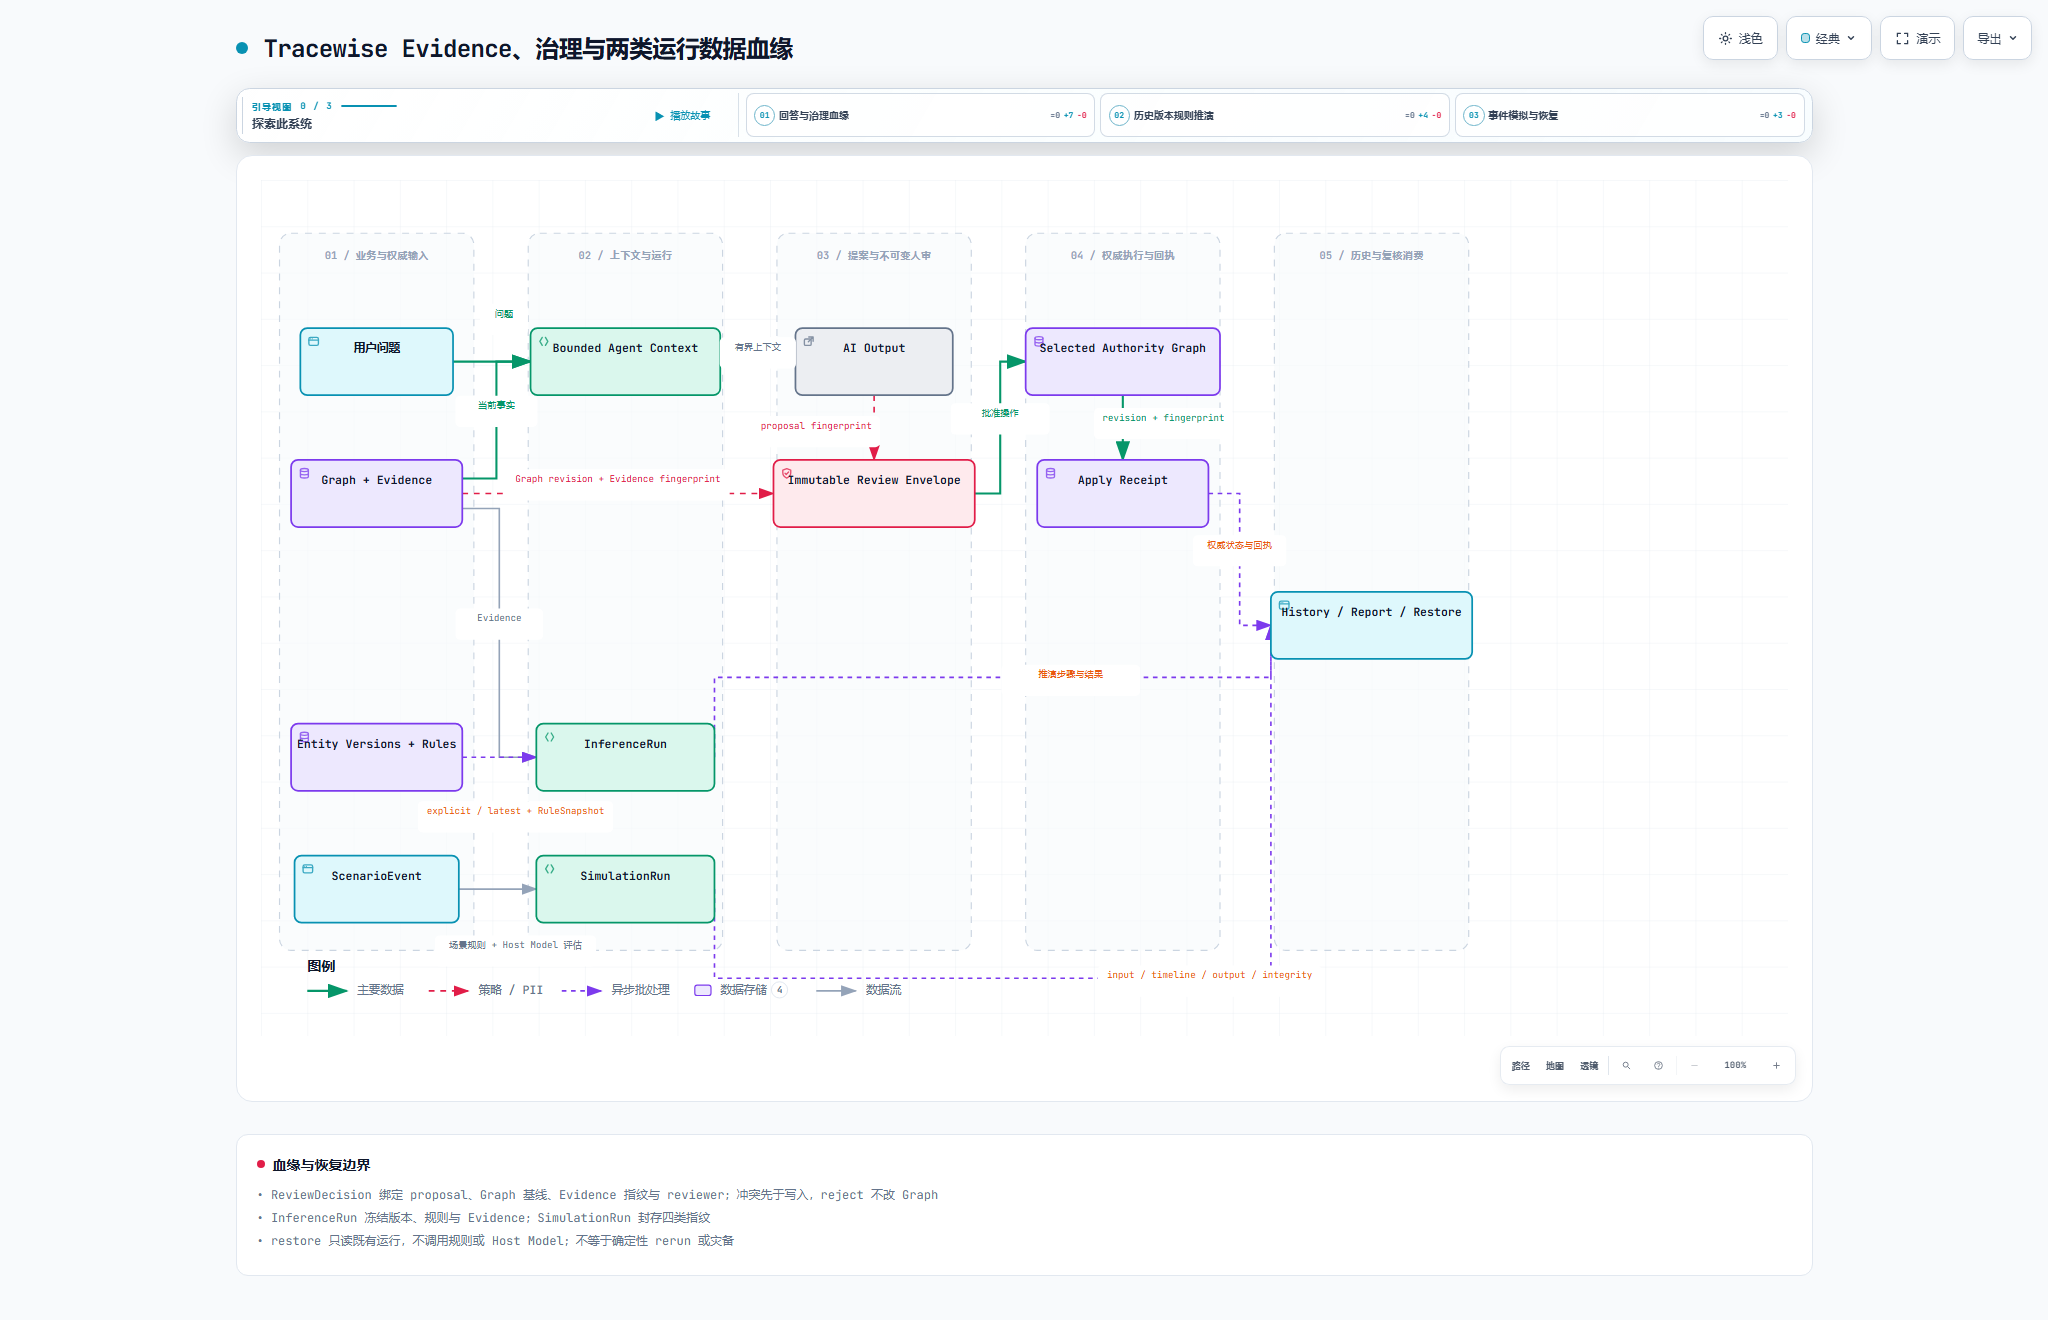
技术解释图:InferenceRun 绑定实体版本、规则快照和 Evidence;SimulationRun 保存 input、timeline、output 与 integrity 指纹,二者进入历史与报告。
SimulationRun 是一次已经发生的执行
Simulation 的创建路径与恢复路径必须先区分。
创建新运行时,SimulationService.start 会:
- 从场景预设中找到
scenario_id; - 保存输入
ScenarioEvent; - 根据事件匹配场景规则;
- 将每次规则命中和 effect 写入 timeline;
- 调用产品拥有的 Host Model 形成评估;
- 保存 risk level、matched rules、recommended actions 等 output;
- 计算四类指纹;
- 将完整
SimulationRun写入 SQLite; - 在有 entity ID 时,把模拟结果写成实体状态版本和 simulation Evidence。
这是一条有副作用的新执行路径。它会读取场景文件、运行规则、调用 Host Model,并可能形成新的实体版本与 Evidence。
因此,任何“查看历史 timeline”的 GET 请求都不应该调用它。
恢复路径如何证明自己没有重新执行
当前 API 把语义写得很明确:
POST /api/simulations:开始一次新执行;GET /api/simulations/{run_id}/timeline:恢复一个已经持久化的运行。
恢复逻辑先查内存 read-through cache;没有命中时,从 SQLite 按 run_id 读取 SimulationRun,校验指纹,再把它放回 cache。找不到就返回 404,并明确说明 restore 不会为缺失运行重新执行。
验收使用了一个比 source inspection 更强的反例:
- 第一个
SimulationService使用 counting model 创建运行,确认模型只调用一次; - 关闭写入端 SQLite store;
- 对同一个 SQLite 文件创建全新的 store 和全新的
SimulationService; - 新 Service 指向一个不存在的场景规则文件;
- 注入一个只要被调用就抛出 AssertionError 的 Host Model;
- 按原
run_id调用get_run。
恢复成功,得到与创建时逐字段相同的 input、timeline、output 和四类 fingerprints;模型调用次数仍是 1。换句话说,新 Service 既没有读取场景规则,也没有再次调用模型。
这才是“restore”的执行证据,而不是看到一个 GET 路由或 HTTP 200 就下结论。
四类指纹分别保护什么
完成的 SimulationRun 会被 seal:
input_fingerprint:绑定input_event;timeline_fingerprint:绑定按顺序保存的 timeline events;output_fingerprint:绑定最终 output;integrity_fingerprint:绑定 run ID、scenario identity、状态、创建/完成时间和前三类指纹。
恢复时,如果四个指纹全部存在,系统会重新计算并比较。只缺一部分会触发 simulation_run_fingerprint_incomplete;内容与指纹不一致会触发 simulation_run_fingerprint_mismatch。
为什么不只 hash output?因为相同输出可能来自不同输入和不同路径。一个 run 即使最后都得到 risk_level=high,也可能来自不同 ScenarioEvent、不同规则命中和不同 Host Model assessment。历史解释需要保护整个链条,而不是只保护结论。
这里也保留兼容边界:旧记录如果完全没有这些 fingerprints,仍可以读取,但不会被追溯描述为拥有当前完整性证明。兼容可读与证据等级是两件事。
Restore、rerun、replay、copy 不是同义词
开发讨论中最容易把以下操作混在一起:
Restore:读取一个已经完成并持久化的 SimulationRun,不执行规则、不调用 Host Model、不形成新结果。
New execution:重新提交 POST /api/simulations,使用当前场景、当前代码和当前 Host Model 创建新的 run ID。它可以用于再次评估,但不能冒充原运行。
Deterministic rerun:冻结所有必要输入和执行环境,再证明重新执行可得到预期等价结果。TraceWise 当前没有提供这个通用合同。
Replay:在其他治理路径中可能指对同一幂等事件或 receipt 的精确重放。它有自己的身份与去重语义,不能因为单词相似就套到 Simulation。
Core-knowledge copy:从项目快照创建隔离的新项目,只复制 Entity、Relation、Evidence 和规则。Simulation runs、Agent interactions、报告、活动和 timeline 明确不复制,因此也不是历史运行恢复或完整备份。
把这些术语分开,不是文字洁癖。它决定了系统是否会产生新副作用、是否依赖当前模型、是否保留原 run ID,以及用户能否把结果当作过去发生过的事实。
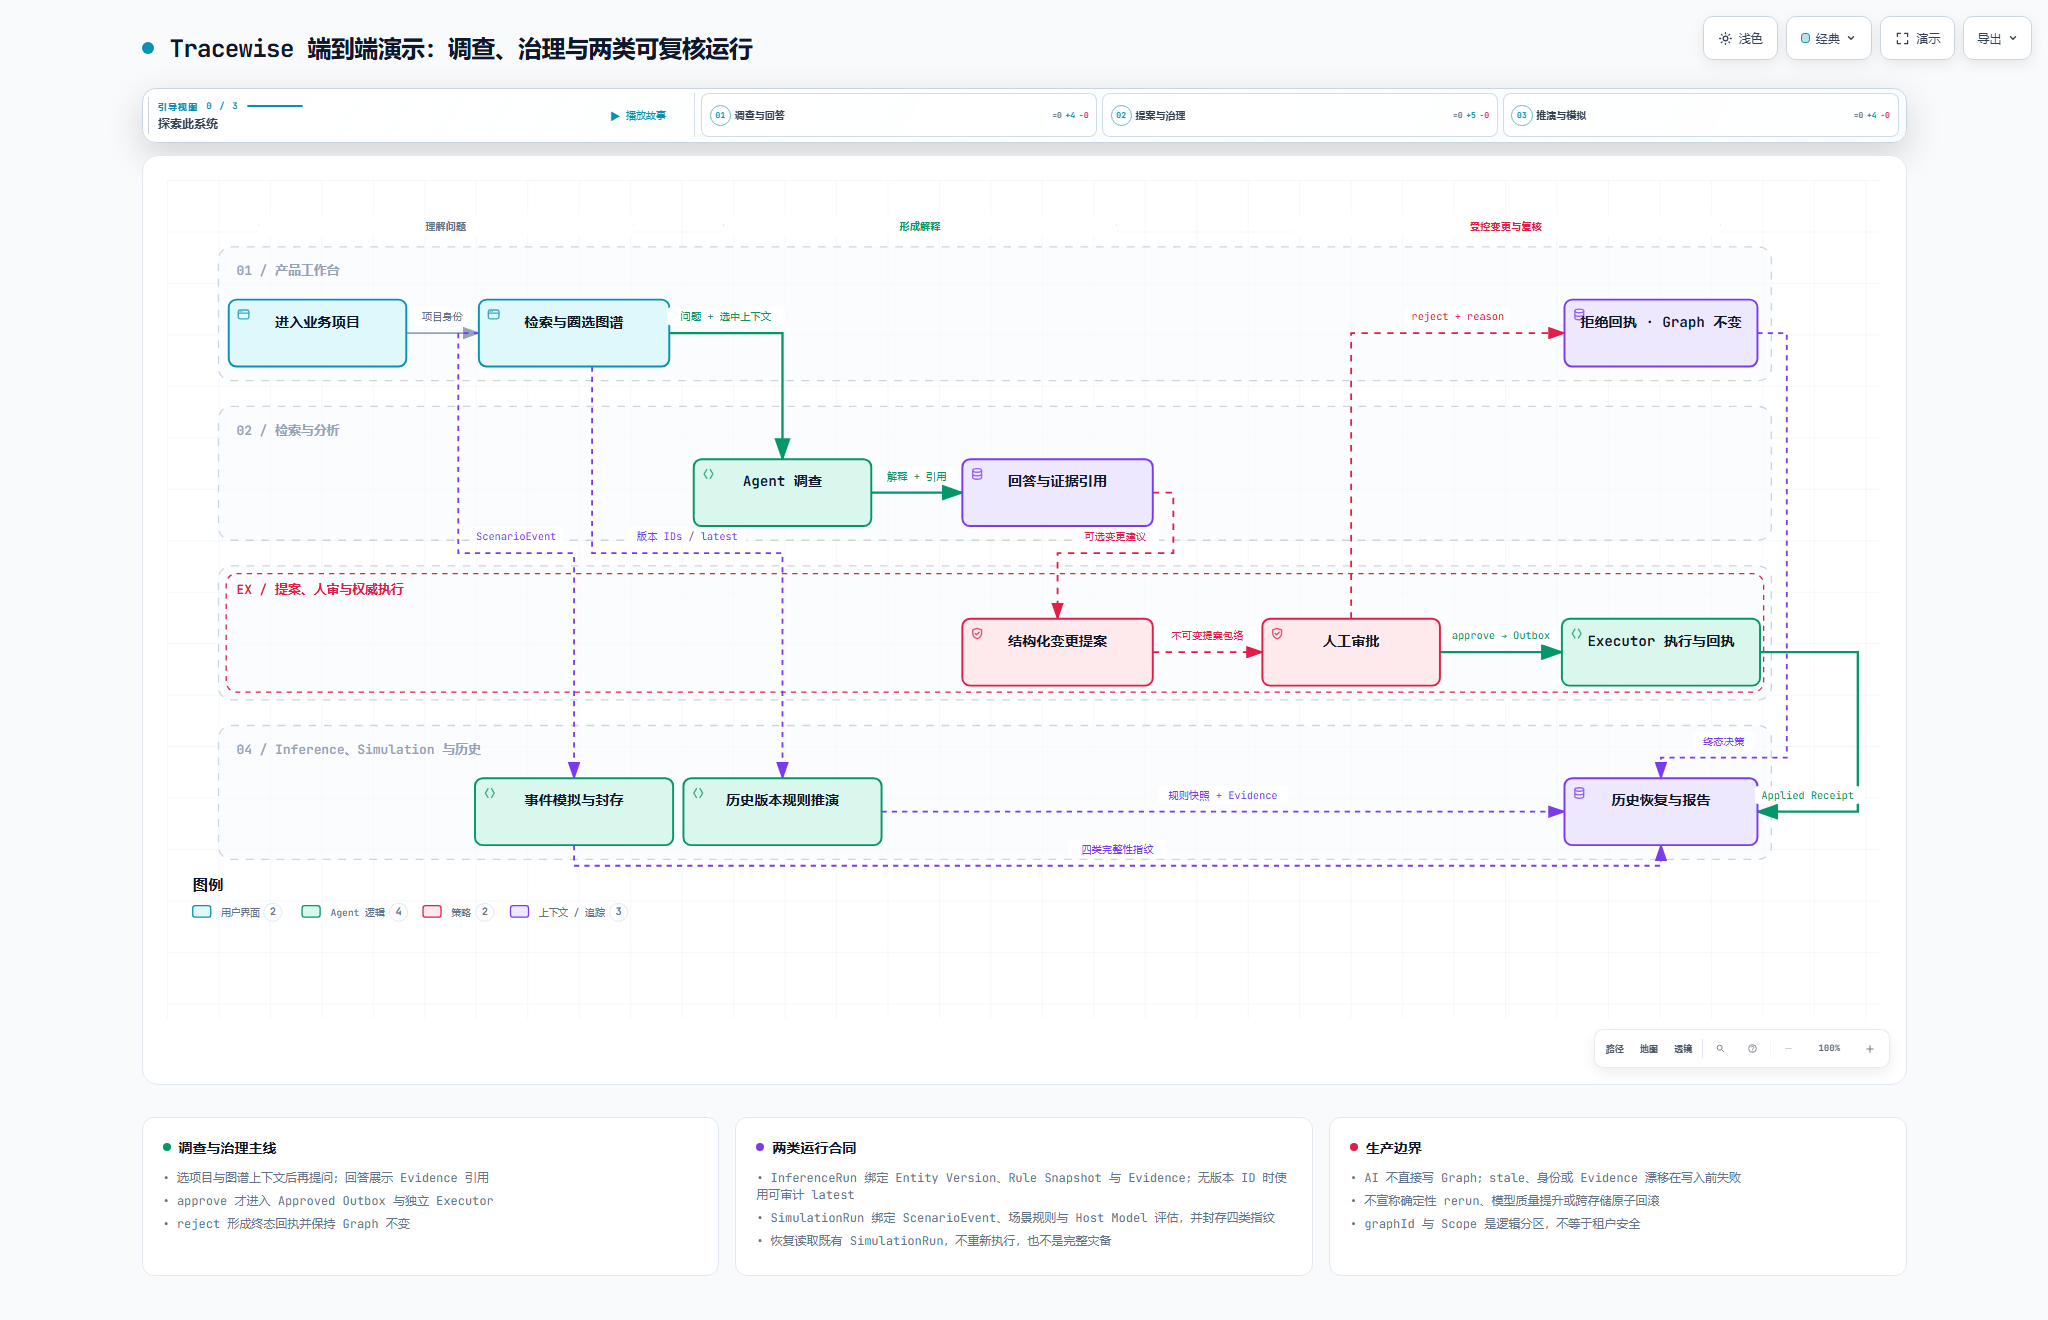
技术解释图:调查、人审与两类运行历史位于同一产品闭环,但每条路径有不同的输入、写入和恢复合同。
五个被拒绝的“省事方案”
1. 只保存用户选择的 version ID
不够。version ID 必须先解析成实际状态,并直接成为规则输入,否则记录与计算可能分叉。
2. 无效版本自动退回 latest
不接受。fallback 会把错误请求伪装成成功历史推演。typed 422 比错误结论更有价值。
3. GET timeline 时重新运行场景
不接受。当前规则和模型可能变化,还会产生新的状态版本与 Evidence。查看历史不能有新执行副作用。
4. 把新的 POST 称为 rerun
不严谨。当前只能说“新执行”。没有冻结完整运行环境,就不能承诺 deterministic rerun。
5. 只给最终 output 做 hash
不够。历史解释需要同时保护 input、timeline、output 和描述它们关系的 run envelope。
这些拒绝项构成了设计边界:历史不是“尽量重算出相似答案”,而是忠实保存并读取已经发生的运行。
我在这项修复中承担了什么
v1 / v2 状态分叉的反例暴露出记录的 version ID 与实际规则输入不一致。修复将 explicit 与 latest 的解析收敛到统一入口,并增加 missing、duplicate、cross-Graph 和 entity-mismatch 负例;旧记录继续使用 legacy_unspecified。
在 Simulation 侧,我把内存运行提升为 SQLite 持久化合同,增加 input、timeline、output 和 integrity 四类 fingerprints;让重新构造的 Service 可以恢复同一 run;再用“场景文件不可读、模型一调用就爆炸”的测试证明恢复不重新执行。最后把 GET restore 与 POST new execution 的语义写进 OpenAPI,而不是只留在开发说明里。
Agent Foundation 只提供了被产品使用的公共稳定指纹能力;场景、规则、Host Model、Simulation 运行和产品历史仍由 TraceWise 拥有。本文不把模型输出质量或 Foundation 能力归因为本次修复成果。
证据范围与当前边界
这项能力的验收从 7 个修复前失败用例开始;修复后 focused regression 为 7 passed,service/API combined regression 为 12 passed,形成该切片时的完整 backend gate 为 101 passed。当前正式 a12 基线继续把历史版本和 Simulation restore 列为 verified,并由后续完整回归覆盖。
没有重新执行的证据来自:新 SQLite store、新 SimulationService、不可读取的 scenario path、会在调用时失败的 Host Model,以及恢复结果与原 run 的逐字段和 fingerprint 一致性。前端没有因这项后端计算与 OpenAPI 修复而改动,因此当时没有重复浏览器验收;本文使用的产品截图也不承担运行恢复证据。
当前可以严谨地说:显式历史版本真正驱动规则;latest 模式冻结当时解析到的 IDs;错误选择失败关闭;已完成 SimulationRun 可以在 Service 重建后从同一 SQLite 恢复,且不重新评估规则或调用 Host Model。
当前不能说:任意旧运行都拥有完整指纹;新 POST 能确定性复现旧结果;项目快照是完整备份;同一 SQLite 恢复等于 HA/DR;模型质量因此提升;或该机制已经过生产故障、长期流量和跨区域灾备认证。
“恢复不是重跑”看起来只是一个 API 命名问题,实际上它决定了系统如何对待历史:过去的结果应该作为已经发生的事实被读取,而不是在今天的规则和模型下重新解释后,再贴上昨天的标签。