返回 TraceWise 项目总览 · 交互图:审核 · 决定 · 证据 · 血缘 / 审核 · 决定 · 治理 · 工作流 / 审核 · 决定 · 生命周期
一个 Graph 变更同时影响 TraceWise 产品状态和 Agent Foundation Memory 生命周期时,最舒服的描述是“任何一步失败都会整体回滚”。问题在于,这句话需要真实的跨存储事务。
当前产品 Authority 路径会先在 TraceWise 中完成审核并写入 Graph,再把同一个决定提交给 Foundation。两边分别拥有自己的数据库与事务。如果 Graph 已经成功,而 Foundation PostgreSQL 此时不可用,应用层没有能力把多个权威存储伪装成一个原子提交。
TraceWise 选择保留真实事实:Graph 已成功;Foundation 尚未同步。状态写成 applied_with_foundation_pending,并允许用户使用同一个冻结决定显式重试。
这篇文章复盘为什么这比“自动回滚”更可靠。
最小失败场景
受控验收先形成一个合法 Proposal:
- Proposal、Graph baseline 和 Evidence 已冻结;
- Reviewer 身份来自认证上下文;
- ReviewDecision 为 approve;
- TraceWise Graph 校验通过;
- Foundation Registration 与资源绑定原本有效。
然后在真正提交 Foundation 生命周期前,让 PostgreSQL 不可用。
实际结果是:
TraceWise Graph: applied
Foundation sync: failed
Product status: applied_with_foundation_pending
reason: foundation_sync_failed
用户目标节点已经出现在 Graph 中,因此不能返回一个让人误以为“什么都没有发生”的通用 500,也不能删除 Graph 结果假装事务回滚。
为什么补偿删除也不等于回滚
一种看似直接的办法是 Foundation 失败后立即删除刚写入的 Graph 节点。这个方案有三个问题:
- 删除本身也可能失败;
- Graph 写入可能已经触发 Timeline、审计或其他读取;
- 补偿操作不一定能恢复原始 revision、索引和并发观察到的状态。
补偿可以是未来某些业务的明确恢复策略,但不能因为代码执行了一个反向操作,就把它描述成数据库原子回滚。
TraceWise 当前没有使用这种掩盖。它保存 Graph 成功的事实和 Foundation failure detail,等待后续对同一决定进行恢复。
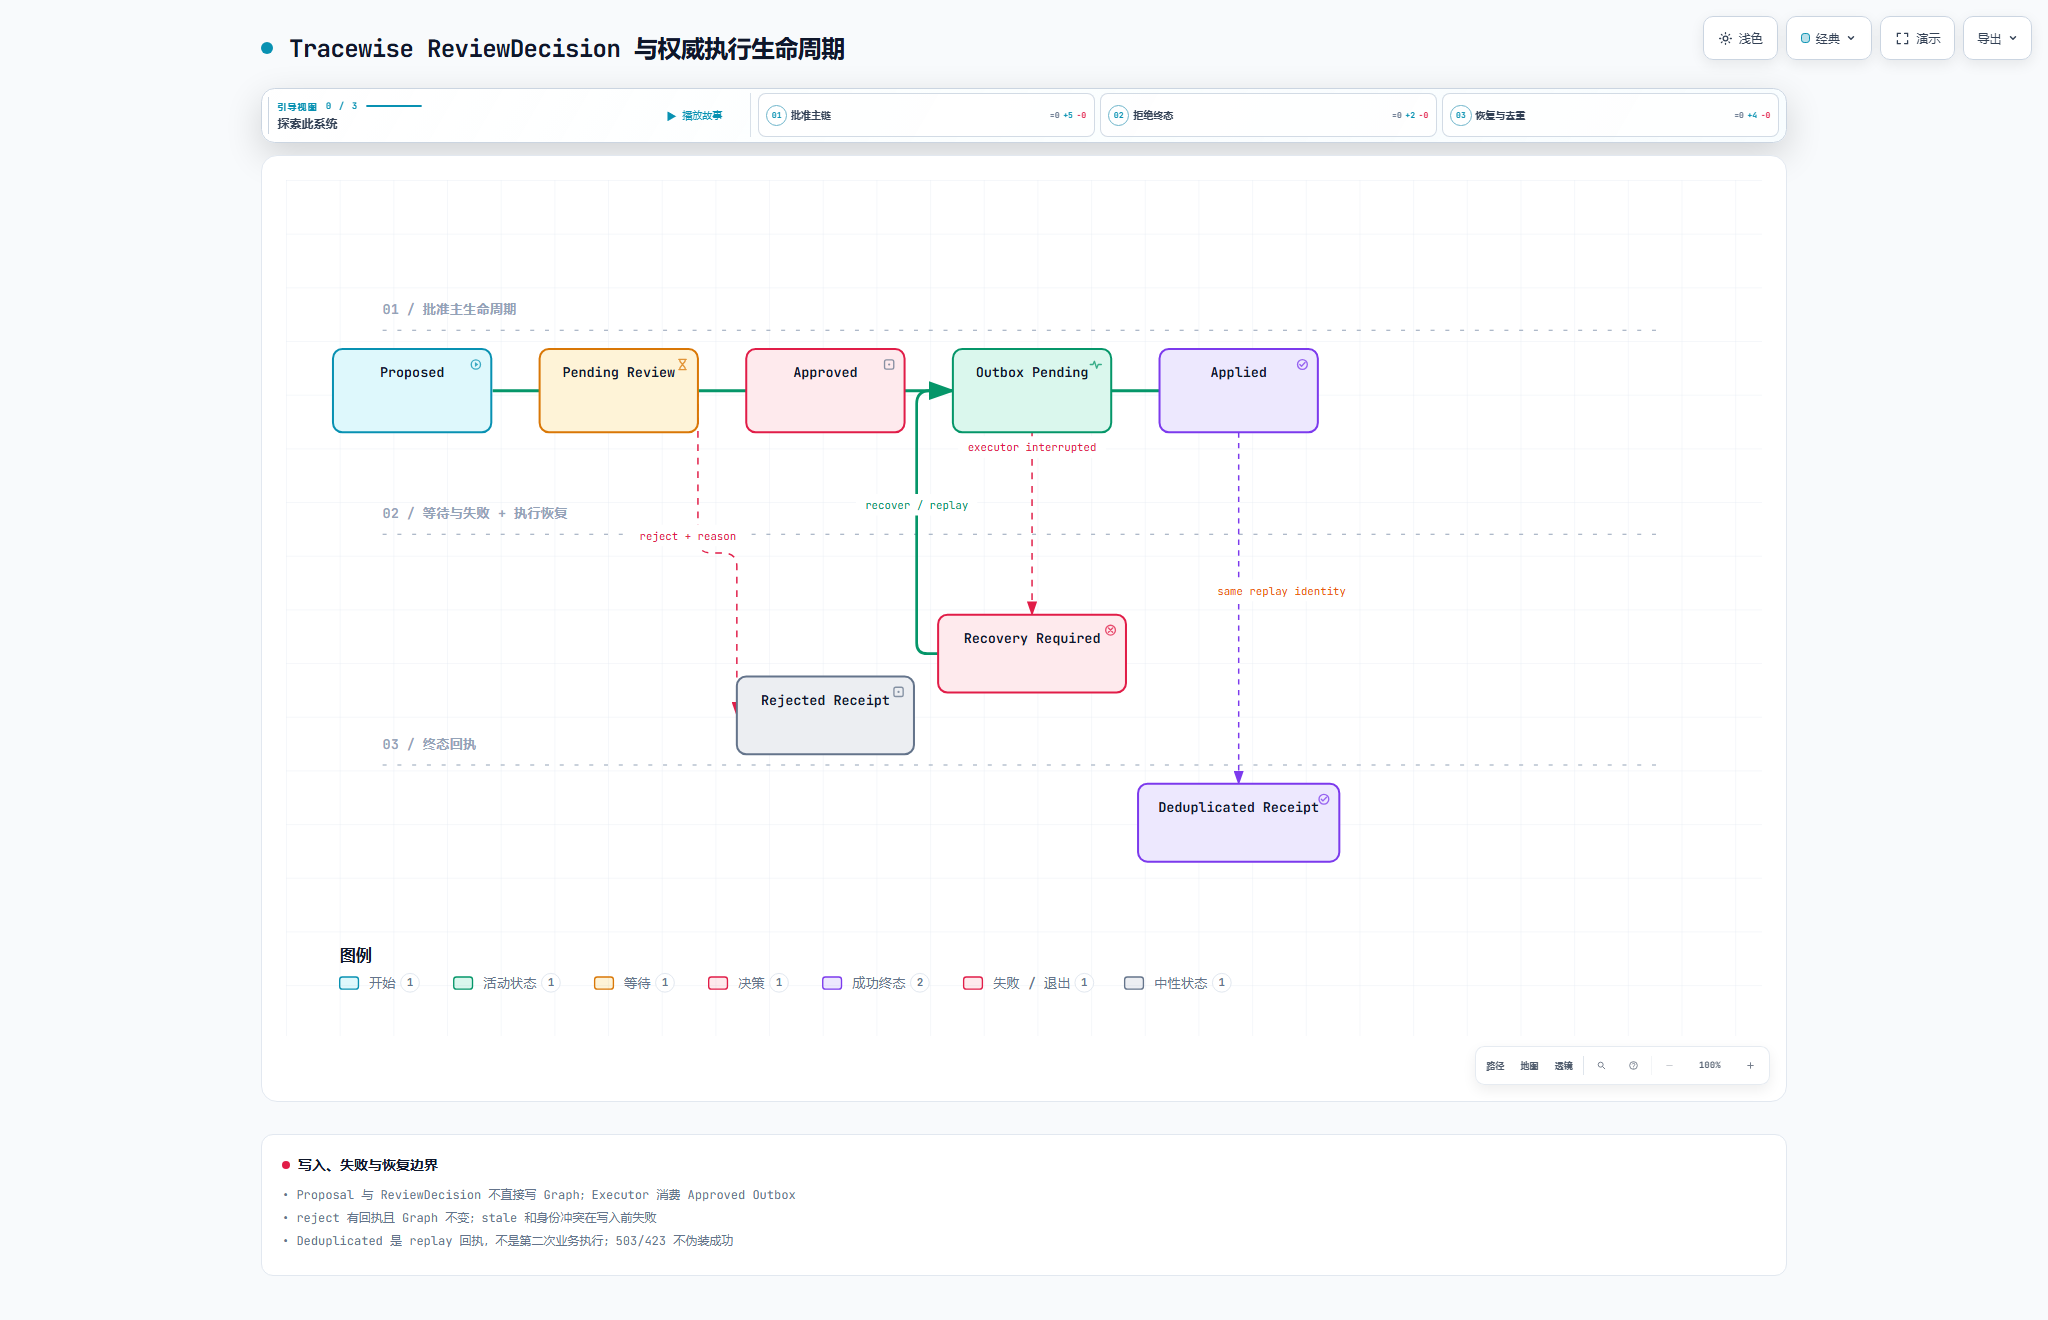
技术解释图:Graph 已成功但 Foundation 未完成时进入显式恢复分支,不回到“未发生”状态。
为什么必须重试同一个冻结决定
恢复时不能重新读取最新 Graph/Evidence 后自动生成另一个决定。那会把“恢复未完成交付”变成“一次新的业务变更”。
原 ReviewDecision 已经绑定:
- Project、Graph 与 Scope;
- Proposal fingerprint;
- Graph baseline revision/fingerprint;
- Evidence IDs/fingerprint;
- Policy revision;
- Reviewer、decision 与 reason;
- replay identity。
显式重试使用同一决定和同一 sync record。这样系统恢复的是审核者当时批准的那一件事,不会在后台把新增 Evidence 或新 Graph 状态偷偷拼进旧授权。
一次恢复、两次重试分别发生什么
验收在恢复 PostgreSQL 后,对原决定执行手动 retry:
- 第一次 retry 重新提交同一 ReviewDecision;
- Foundation 验证 Registration、Scope、资源和 Evidence 绑定;
- Memory 生命周期完成;
- 原 sync record 从 pending 更新为 applied;
- 第二次 retry 返回
deduplicatedreceipt; - Graph 与 Memory 都没有重复 transition。
系统还限制最多尝试 5 次,避免一个永久失败的绑定被无限重试。达到上限后需要人工检查,而不是继续制造后台噪音。
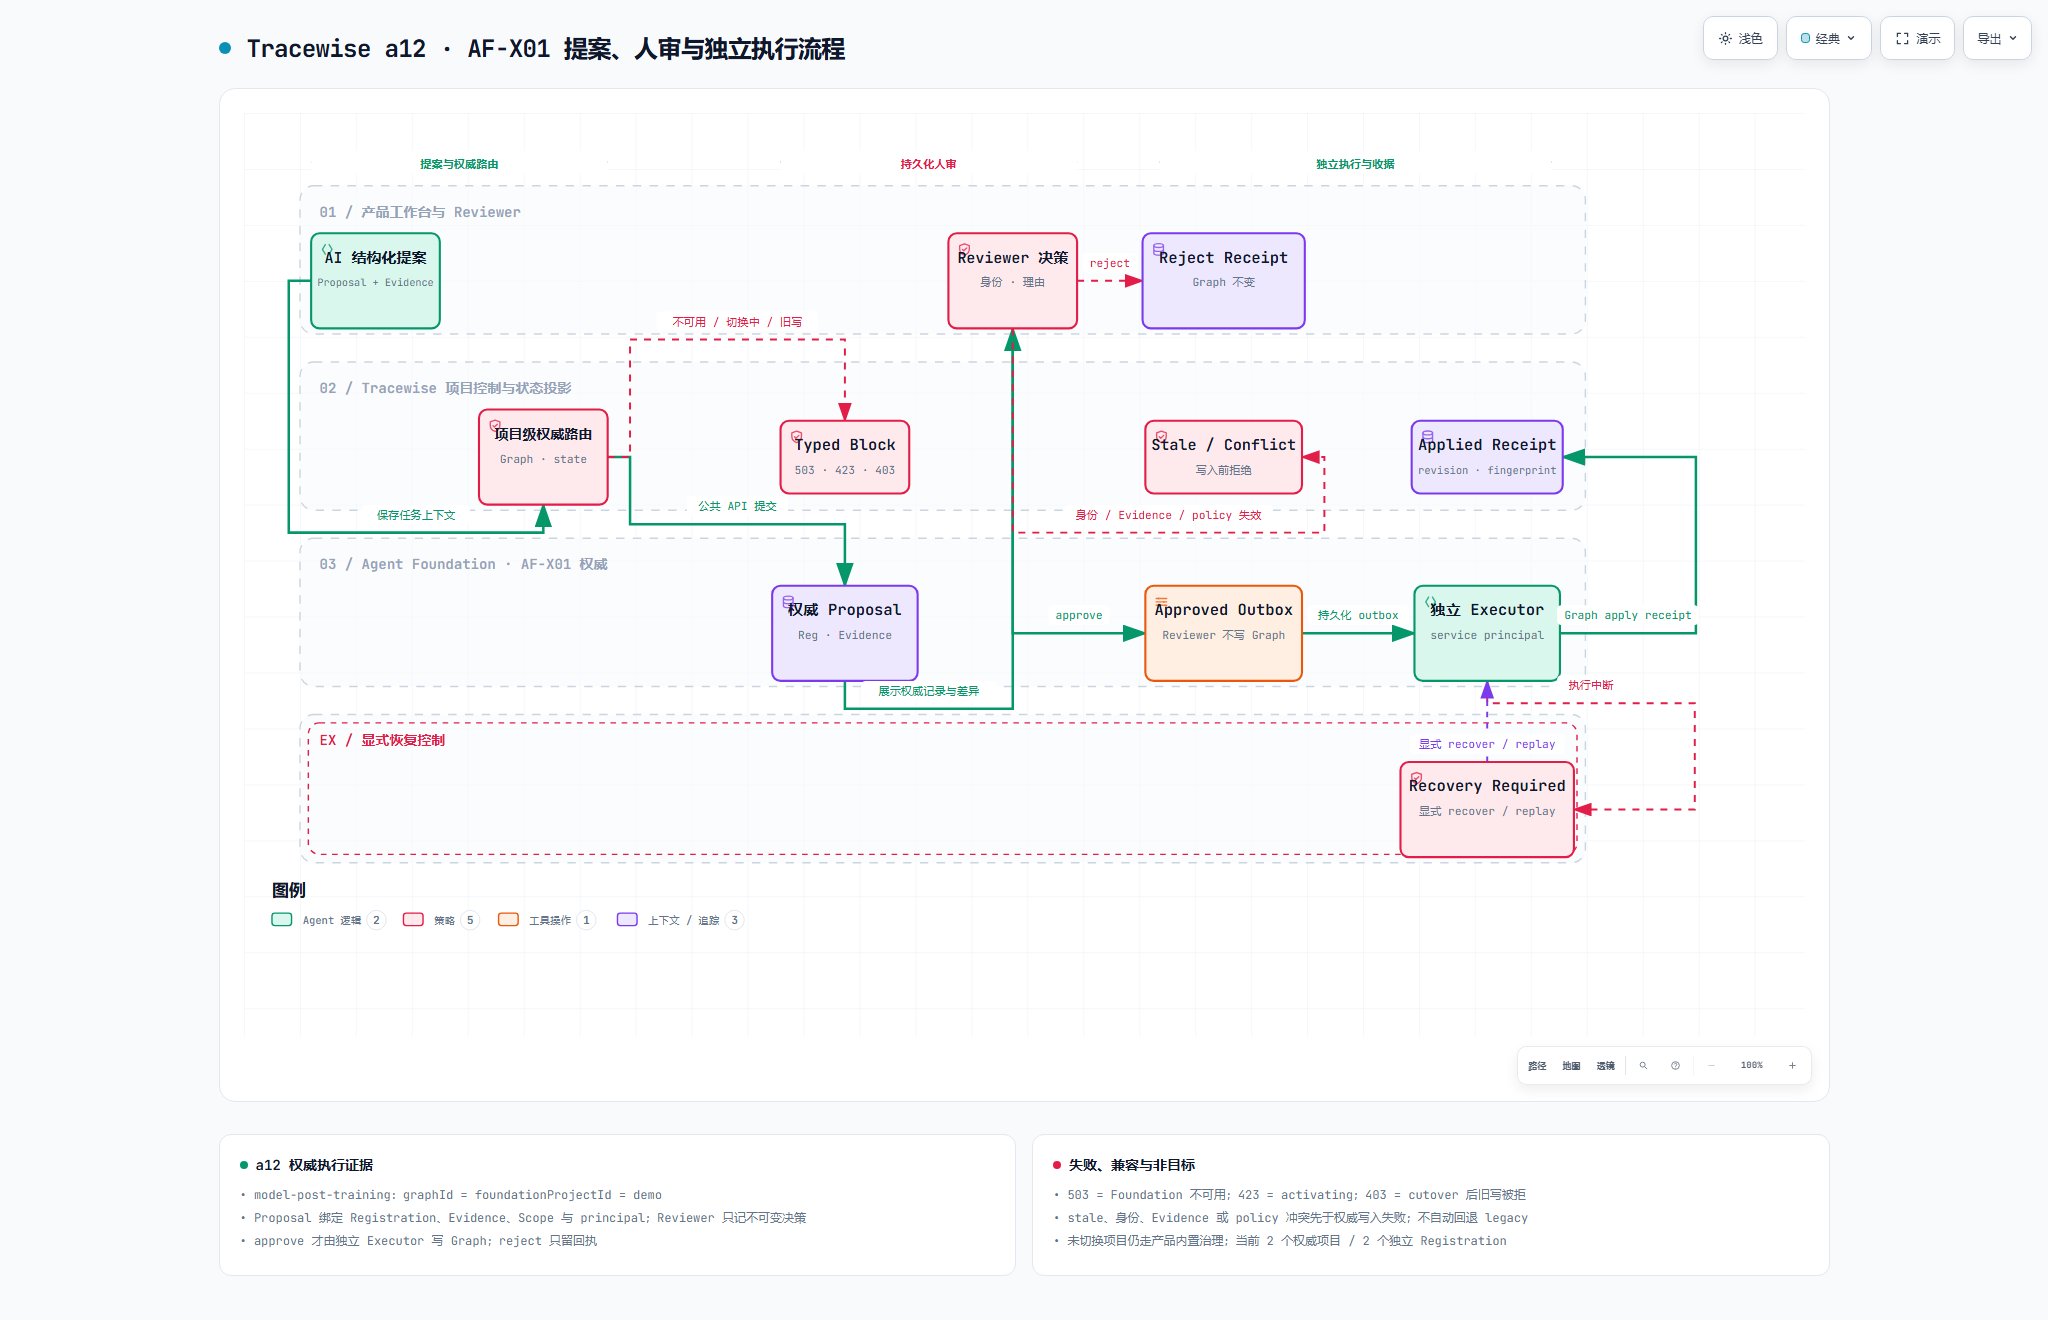
技术解释图:同一冻结决定贯穿审核、执行和恢复;重试不是重新审批或重新生成 Proposal。
Pending、Degraded、Stale 与 Conflict 必须分开
跨存储故障很容易被统一压成 409 Conflict,但这些状态需要不同处理:
| 状态 | 含义 | 下一步 |
|---|---|---|
| pending | Foundation 暂时未完成,原决定仍可恢复 | 对同一决定重试 |
| degraded | Foundation 返回资源状态不允许当前 transition | 人工检查资源 Authority |
| stale | Graph、Evidence、Policy 或资源 revision 已改变 | 重新形成 Proposal/Review |
| conflict | 已存在相反终态决定 | 不允许覆盖 |
| deduplicated | 同一 replay 已完成 | 返回既有 receipt,不重复写入 |
例如,Foundation 资源已经从 candidate 变为 archived 时,再提交 activate 会返回 resource_compare_and_set_failed。这不是网络 pending,也不能靠重复请求解决。TraceWise 保存返回的 persisted=false stale receipt,而 Foundation 事务正确回滚、不写 terminal receipt。
用户界面不需要第二套审批
恢复状态继续出现在现有 AI Change Panel。用户先看到业务决定、reason、Graph/Evidence lineage 和 stale 状态;Foundation status 与 receipt 折叠在下方,pending 时出现明确 retry 动作。
这避免了两个问题:
- Foundation 失败后要求用户再批准一次同一业务决定;
- 新建一个“平台治理页面”,让用户在两套审批语义之间切换。
Foundation 独立验证同一决定,但不形成第二个人工批准。
产品 Authority 路径与 AF-X01 路径不能混写
本文的真实 PostgreSQL outage/retry 证据来自未切换项目的产品 Authority 路径:TraceWise 先应用 Graph,再同步 Foundation Memory。
已显式 opt-in 的 AF-X01 项目使用另一套真实实现:Proposal、approved outbox、独立 Executor 和 recovery state machine。Reviewer 不直接写 Graph,Executor 在 Foundation Authority 下执行。两条路径共享冻结决定、Evidence lineage 和失败关闭原则,但存储顺序、状态机和恢复动作不同。
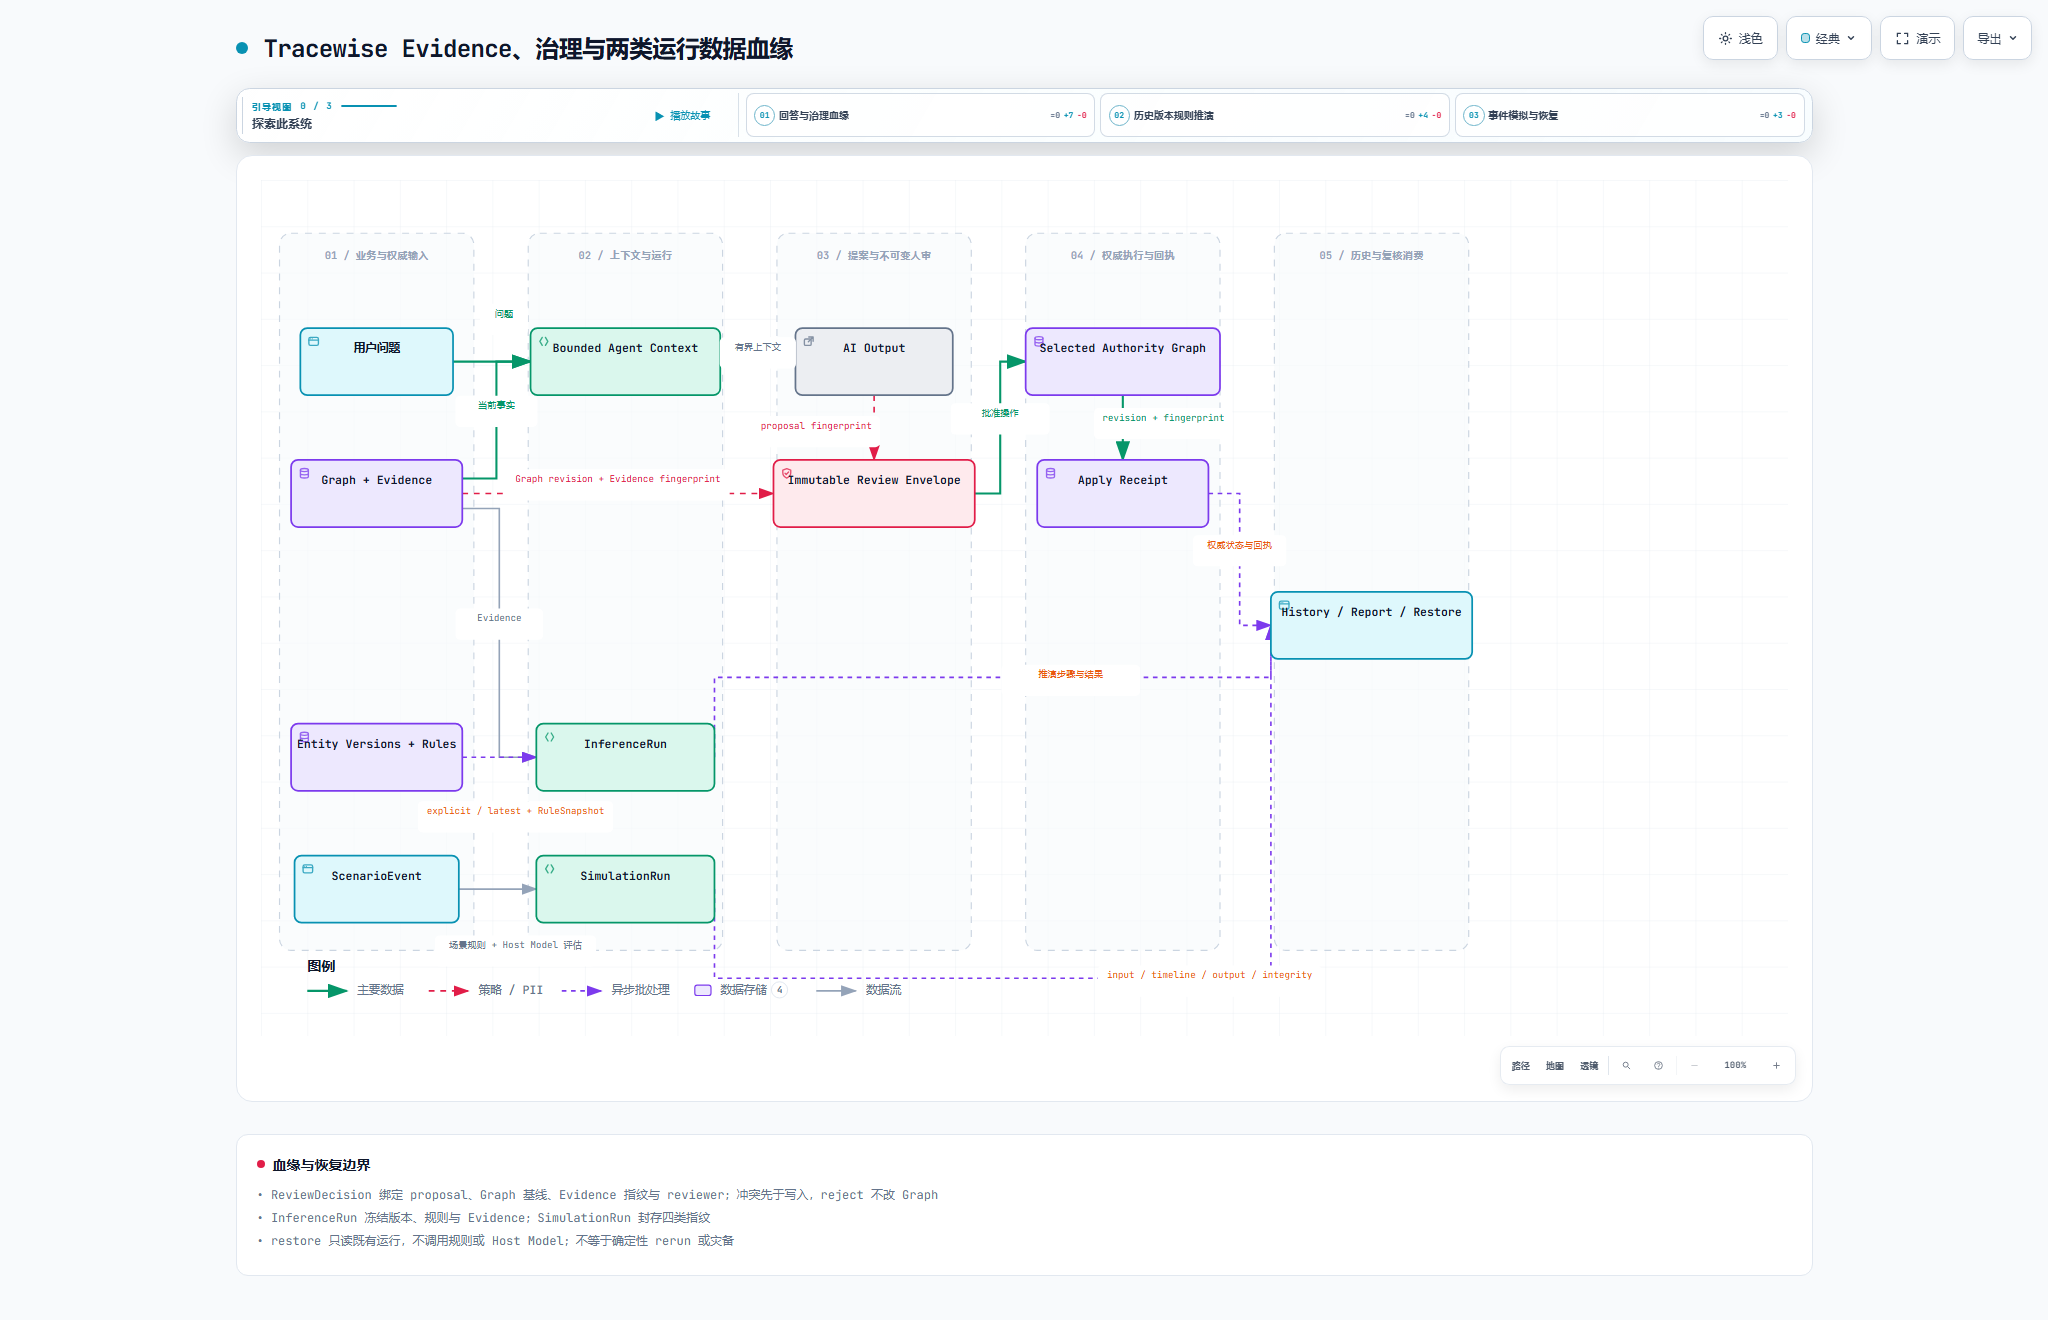
技术解释图:无论采用哪条执行路径,恢复都必须回到原始 Proposal、Evidence 与决定血缘。
这次故障证据证明了什么
受控验收包含:
- 真实 PostgreSQL 不可用;
- TraceWise Graph 已写入;
applied_with_foundation_pending状态;- 恢复同一数据库后的手动 retry;
- 原 sync record 更新为 applied;
- 第二次 retry deduplicated;
- direct apply 被拒绝;
- approve、reject、stale、conflict 等相邻路径。
它没有证明自动后台恢复、跨存储原子事务、生产 HA 或一般化灾难恢复。
可复用的失败语义
部分成功需要单独的状态:它决定恢复时应重试未完成的交付,还是重新审核业务决定。
TraceWise 的处理顺序是:
- 冻结业务决定与 Evidence;
- 每个 Authority 只声明自己真实完成的状态;
- 保存未完成交付的 sync record;
- 用同一 replay identity 恢复;
- 区分 pending、stale、conflict 与 deduplicated;
- 对重试设置上限并保留人工出口。
恢复入口需要展示三项信息:哪一边已经成功,哪一边仍未完成,以及重试将继续执行哪一个被批准的决定。