返回 TeachFlow 项目总览 · 交互图:AI · 课程 · 生成 · 工作流 / 结构化 · RENDERING · 架构
同一个提示词交给模型两次,可能得到两套不同的 HTML、两张不同的受力图,甚至两种不同的公式排版。对于一次性内容预览,这种差异也许可以接受;对于教师要编辑、保存、发布并反复使用的课堂内容,它会变成产品缺陷。
TeachFlow 最初也走过“让 AI 直接生成 HTML + CSS”的路。结果并不是不能显示,而是排版质量、交互方式和样式一致性都由模型临场决定。继续增加 Prompt 和预制 CSS 类只能改善个别输出,没有改变“模型同时负责讲什么和怎么画”这个根因。
最终的设计不是消灭生成式 AI,而是重新分配职责:
模型:规划课程、组织内容、提取结构化参数
系统:校验协议、确认上下文、选择渲染器、保存版本
确定性内核:计算事实、派生图形、拒绝非法输入
教师:确认大纲、修改内容、决定是否发布
本文讨论的“确定性渲染”只指受控配置、组件和精确内核。它不意味着课程生成的所有环节都已经确定,也不意味着模型输出天然正确。
被放弃的两条路
第一条路是模型直出完整页面。它拥有最大的自由度,也让产品失去对布局、交互、可访问性和后续编辑的控制。
第二条路是继续强化 Prompt 和 CSS 约束。它可以规定颜色、间距或类名,却无法保证模型每次都选用正确结构,更无法让课程数据自然支持重排、迁移、版本冻结和多种渲染引擎。
图形生成也经历了相似的选择。直接让模型写 SVG 可以覆盖长尾内容,但同类受力图的箭头、标签和比例可能变化;全部改成手工组件又会让覆盖范围受限。TeachFlow 最终采用双轨:高频、标准化内容优先进入受控组件,长尾内容保留通用 SVG、HTML Sandbox、图片或纯文字降级。
这个决策的重点不是“JSON 比 HTML 高级”,而是 JSON 能成为职责边界。模型只能填写系统允许的字段;页面结构、运行方式和错误处理仍由产品代码决定。
第一步:先确认生成依据,而不是直接拼 Prompt
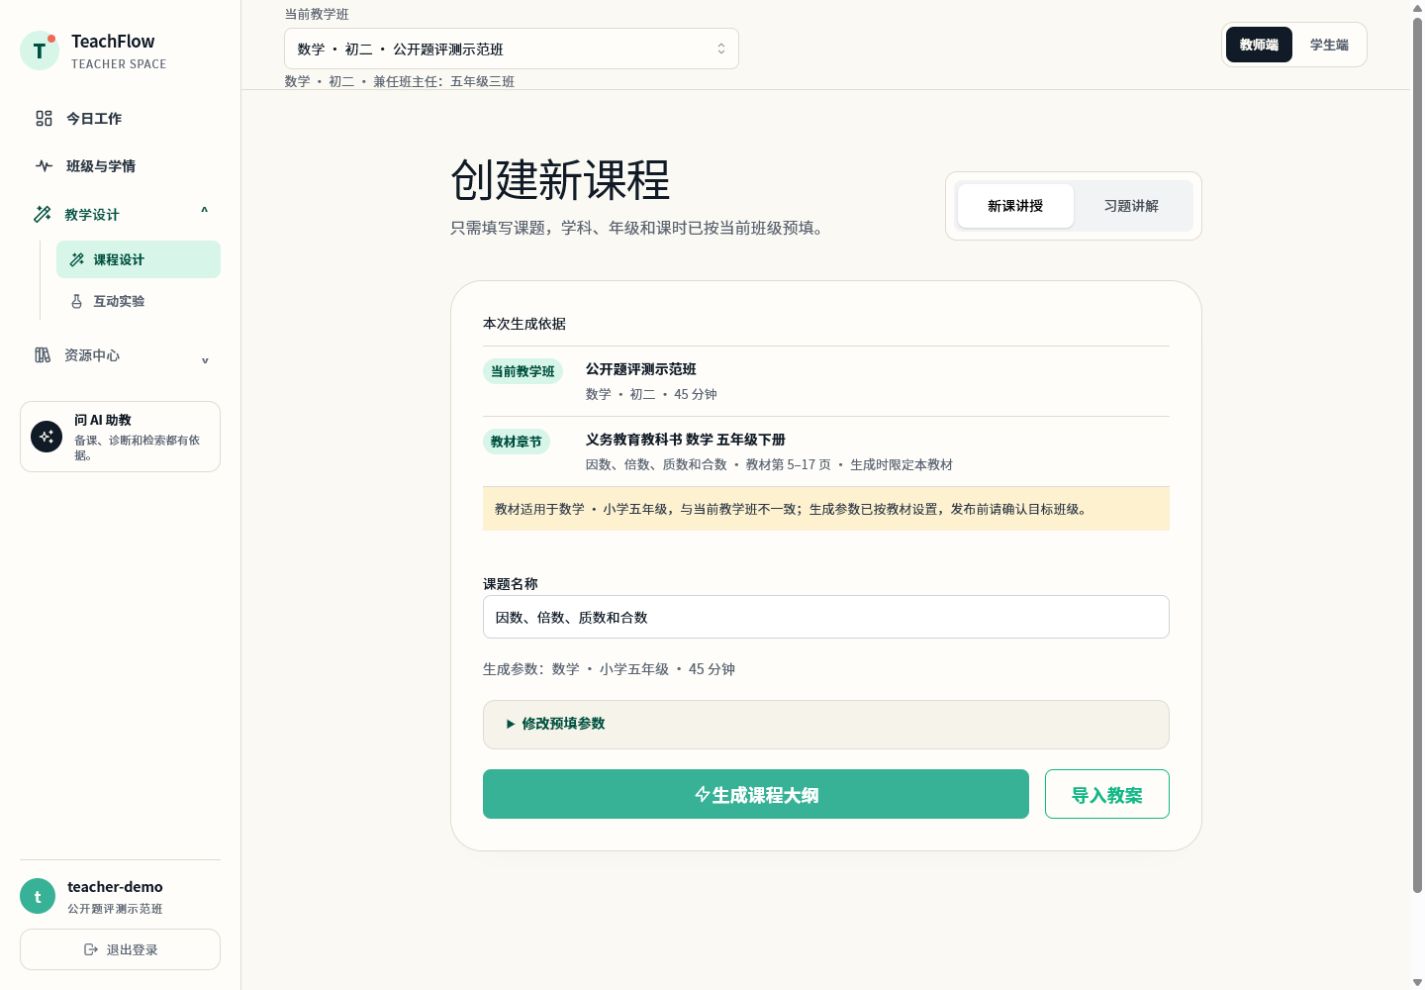
课程生成页会把当前教学班、学科、年级、课时和教材章节展示给教师。截图来自项目内的合成演示班级;其中教材年级与教学班不一致,页面没有静默吞掉冲突,而是要求发布前重新确认目标班级。
可见提示并不是安全边界。真正调用模型前,服务端还会重新检查任教关系、班级当前图版本、知识点目录、教材和章节是否存在,以及教材学科、年级是否与课程一致。浏览器传入的是 ID,模型得到的是服务端根据当前权威数据重建后的名称和约束。
教材召回同样保留三种状态:grounded、no-match、unavailable。只有真实命中才携带教材片段;没有命中或服务异常不会被包装成“已有教材依据”。
第二步:模型先生成大纲,教师确认后才生成场景
大纲不是一段自由文本。它必须包含标题、学科、年级、课时、教学目标和场景列表;每个场景都有类型、时长、目标、知识点和建议方法。系统还检查第一幕必须是 title、最后一幕必须是 summary,各场景时长之和必须等于课程总时长。
通过结构校验也不等于马上生成整节课。教师可以修改目标、场景顺序、难度和讲解风格,确认后系统才逐场景请求内容。
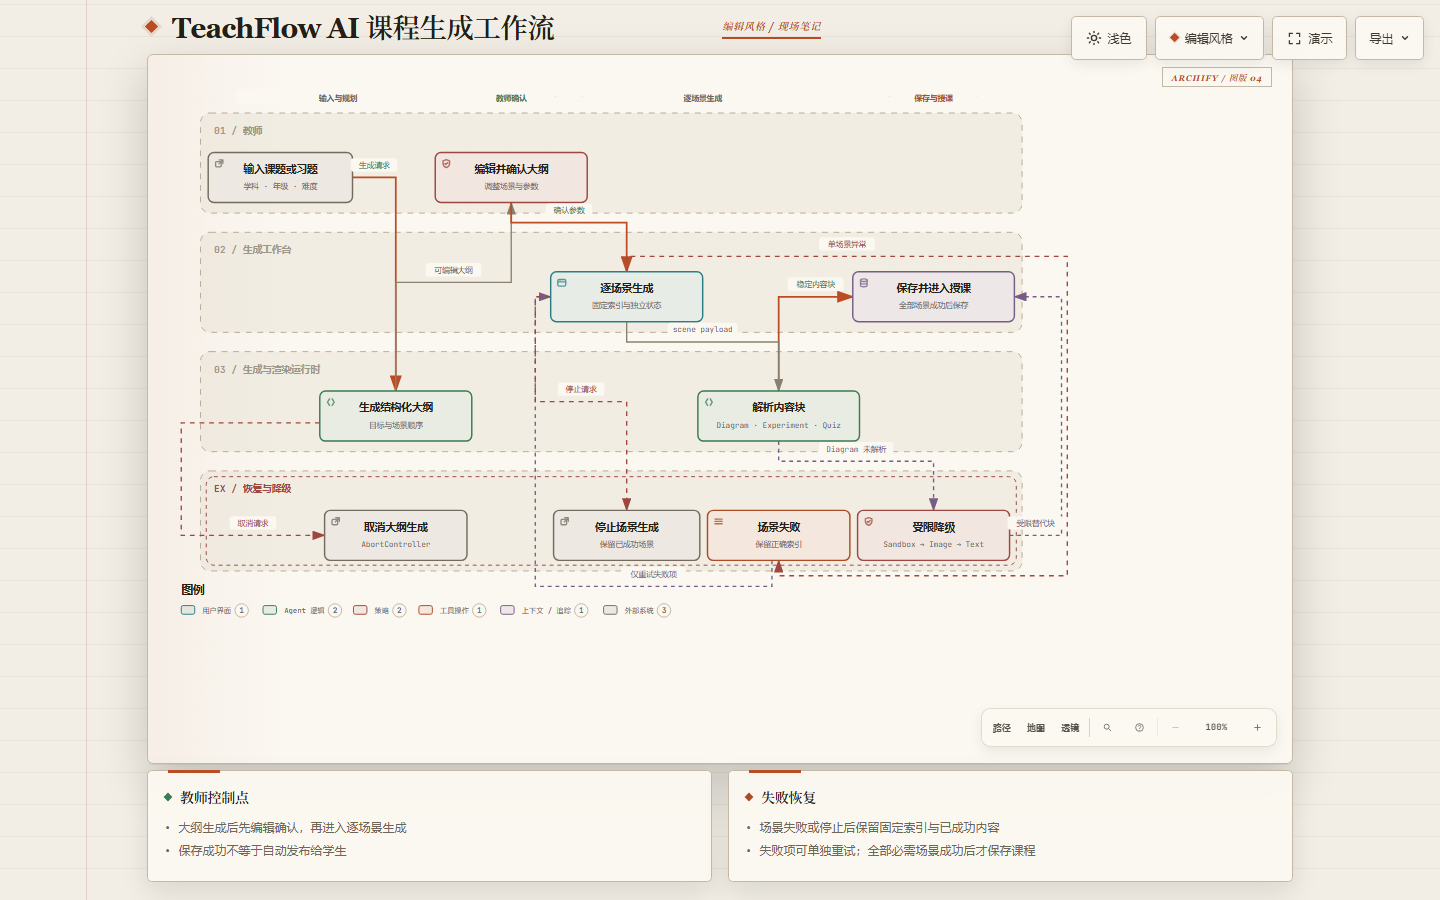
这条流程刻意没有使用“一次请求生成整节课”。逐场景生成允许系统展示进度、停止后回到大纲、复用未修改场景,并在单个场景失败时保留已经成功的内容。只有所有场景都成功,课程才会写入 Lesson Store;保存课程仍不等于发布给学生。
第三步:SceneData 是模型与产品之间的协议
场景返回的不是 DOM,而是 SceneData:
interface SceneData {
  template: TemplateType
  title: string
  blocks: ContentBlock[]
  experiment?: ExperimentConfig
  quiz?: QuizConfig
  knowledge?: KnowledgeGrounding
}
ContentBlock 再把正文、公式、列表、重点、图形、表格、题干、分析、解题步骤、易错提醒、变式、图片和受限 HTML 分成不同类型。React 渲染器根据 block.type 选择固定组件;Diagram block 继续根据 diagramType 进入预制图、ECharts、SVG 或精确几何路径。
运行时会检查模板是否与大纲一致、blocks 是否非空、Diagram 类型是否在白名单、步骤数是否与 blocks 一致,以及实验和测验是否包含必要字段。题目讲解还有额外合同:必须有 3–8 个连续编号的 solution-step;详细模式要求题干、审题、知识点、最终答案、易错提醒和变式,精炼模式则禁止偷偷塞入这些扩展结构。
校验失败会把具体原因反馈给模型,最多重新生成两次。达到上限仍不合法,就显式失败,而不是把半结构化内容塞进页面。
这里需要保留一个真实边界:当前 SceneData 有运行时结构检查,但并非每一种 ContentBlock 的每个字段都已经由统一完整 Schema 逐字段验证。尤其通用 Diagram 路径目前会解析 JSON,却没有对所有图形配置执行同等强度的逐类型校验。这是“结构化”与“已经完全可信”之间必须保留的差距。
第四步:同一协议路由到不同的确定性能力
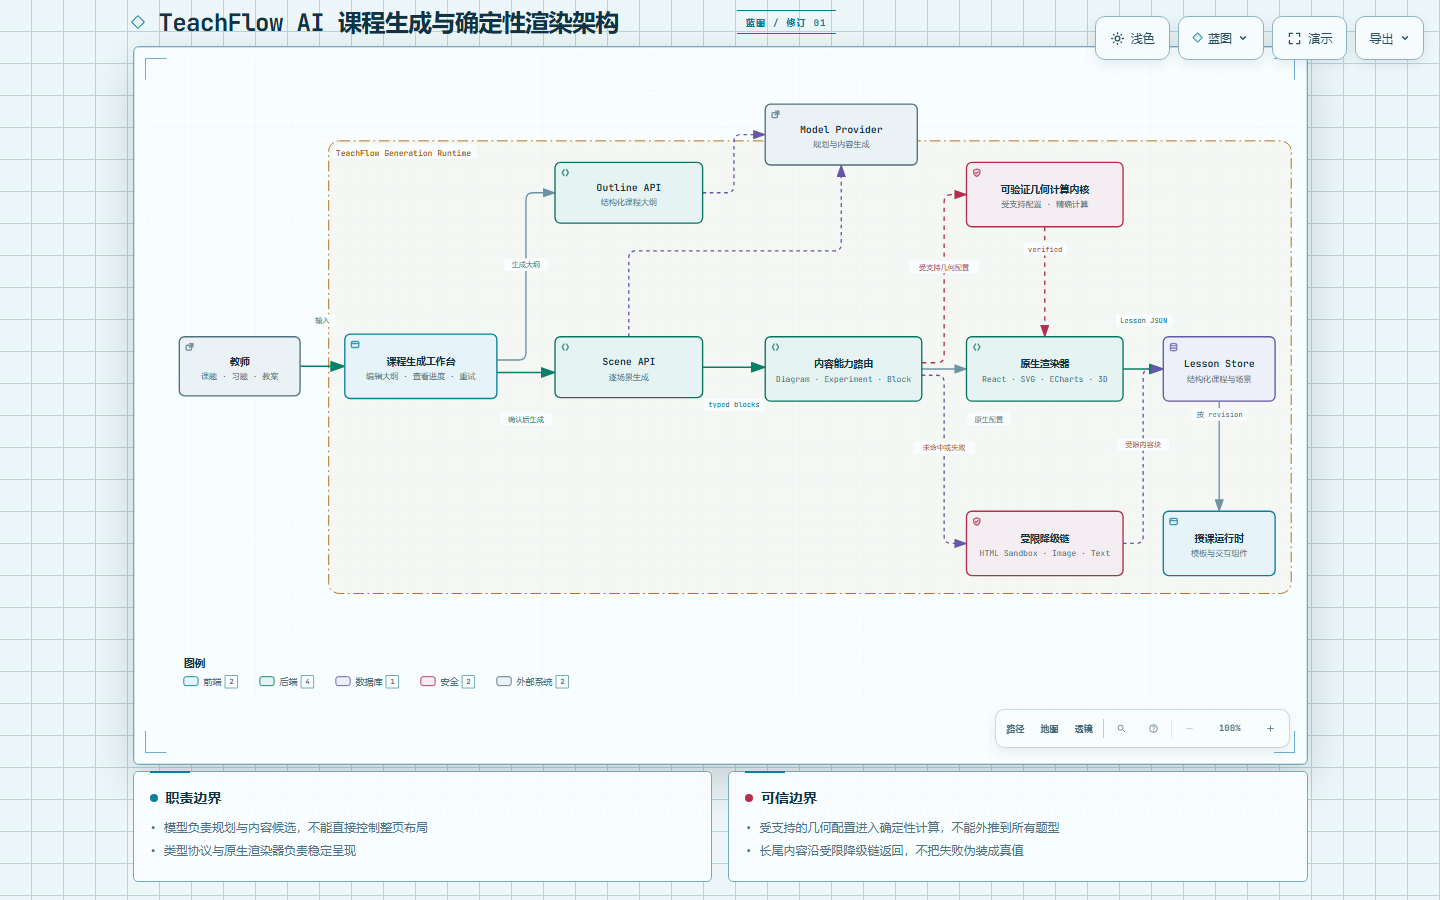
系统把课程生成拆成两类能力。
第一类是稳定呈现。文字、公式、列表、步骤卡、预制图形和实验由固定 React 组件渲染。模型不决定页面的网格、按钮、动效或组件结构;相同的已验证配置进入同一渲染器。
第二类是精确计算。对于受支持的解析几何、立体几何、受力分析和化学方程,模型只负责把问题转换为受控规格,数学或领域内核负责求解、拒绝退化输入,并把同一结果交给答案、步骤和图形。精确几何规格不完整时,接口返回 422,不允许模型猜测关键尺寸。
本轮重新执行了几项不调用外部模型的合同检查:
- 立体几何与实体图:3 个共享场景、9 个拒绝案例、100 次确定性重放通过;
- 受力图:精确笛卡尔向量、平衡与合力分析、限制条件和 100 次重放通过;
- 化学方程:受控公式 AST、原子守恒、唯一最简配平、歧义与预算拒绝、100 次重放通过;
- 知识点建议:30 条结构化合成场景中 precision 与 recall 均为 1,主动弃权率为 0.2333,零非法目录 ID,重复结果一致,本机 P95 为 0.491 ms。
最后一组数字只证明这 30 条固定合成样本上的确定性映射与弃权策略,不是外部模型准确率,也不能代表真实教师数据分布。
参数实验为什么比模型现场计算更可靠
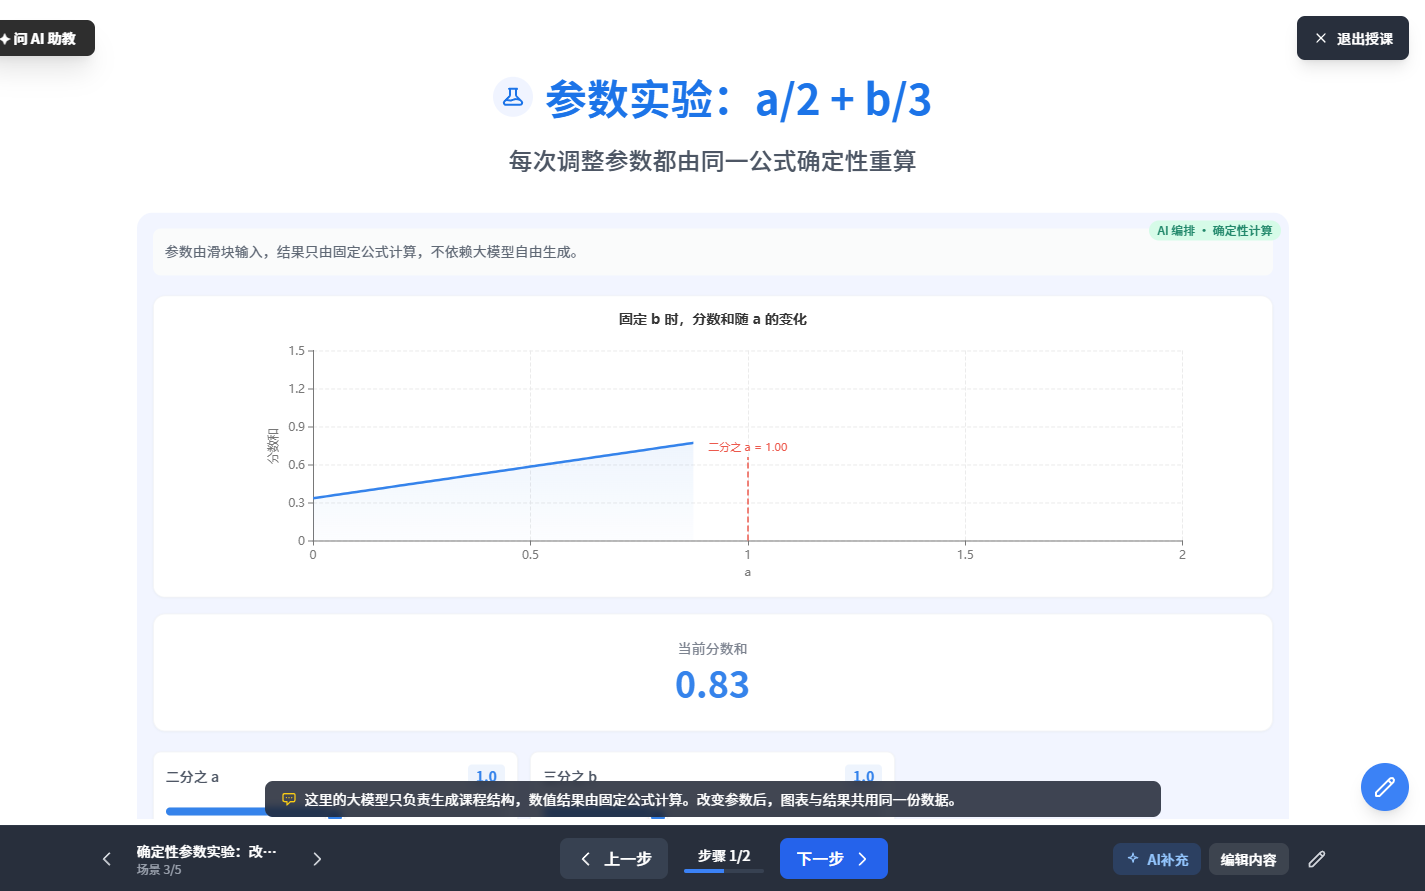
上图来自合成 Golden Demo。参数实验由滑块提供 a、b,结果使用固定公式 a/2 + b/3 重算,图表和数值读取同一份参数结果。模型可以决定“这节课需要一个参数实验”,却不在学生每次拖动滑块时重新生成答案。
这种分工带来三个直接收益:
- 同一输入可以重复得到同一结果;
- 数值、图表和讲解可以共享数据源,减少相互矛盾;
- 运行时不依赖模型延迟、限流或临时语言变化。
但截图只能证明这个演示实验的行为。它不能替所有实验公式做正确性背书,也不能证明模型总能选择正确的实验类型。
长尾内容如何失败,而不是如何伪装成功
预制组件不可能覆盖所有课堂图形。遇到未解析的 Diagram block 时,生成页会按顺序尝试:
标准 Diagram 配置或 SVG
  → HTML Sandbox
  → AI 图片
  → 纯文字描述
HTML 运行在只开放 allow-scripts 的 iframe 中,并把运行错误回传到明确的失败和重试界面。所有图形路径都失败时,页面至少保留原始文字描述,不留下一个看似正常的空白框。
这条降级链解决的是可用性,不是事实正确性。通用 HTML、SVG 和 AI 图片没有获得与精确内核相同的数学或学科验证,不能因为“显示出来了”就标记为已验证。对高风险内容,更安全的产品策略仍应是显式降级和教师复核。
这套设计付出了什么代价
确定性组件并不是免费答案。
- 每增加一种受控图形,都需要规格、验证器、渲染器、负例和回归测试;
- 类型协议需要维护兼容性,旧课程不能因为新字段出现就无法播放;
- 结构校验只能验证形状,无法自动证明教学目标合理、讲解严谨或题目事实正确;
- 长尾回退保留了模型不确定性,因此产品必须区分“精确内核已验证”和“模型生成待复核”;
- 组件渲染稳定,不代表字体、浏览器、WebGL 或第三方依赖在所有设备上完全一致。
TeachFlow 接受这些成本,因为课程会被保存、编辑、发布和回看。只要生成内容进入长期业务流程,协议和失败语义就比一次生成时的自由度更重要。
常见问题与设计边界
“为什么不直接要求模型输出合法 React 或 HTML?”
因为语法合法只说明能运行,不说明布局稳定、交互一致、数据可编辑或历史可迁移。结构化协议把模型自由度限制在内容层,让产品代码拥有页面和运行时。
“既然 SceneData 已经校验,为什么还说不完全可信?”
当前检查主要覆盖顶层结构、模板、块类型和部分专属合同。并非所有 Diagram config 都有统一逐字段 Schema;自然语言到参数的提取也仍可能错。结构正确、计算正确和教学正确是三个不同层次。
“确定性渲染是不是会限制创新内容?”
会限制无边界自由生成,所以系统保留通用 SVG、HTML、图片和文字降级。取舍不是二选一,而是让高频、高风险内容优先走强合同,让长尾能力保留但明确降低证据等级。
“为什么要逐场景生成,不并行一次完成?”
逐场景让教师可以看到进度、停止任务、保留成功结果并只重试失败场景,也避免一次失败清空整节课。当前实现选择可恢复性和模型压力可控,代价是总耗时可能更长。
“这些测试能证明模型生成课程更准确吗?”
不能。合同检查证明的是受控内核、拒绝边界和确定性重放;30 条映射样本证明的是固定合成数据上的规则。模型教学质量仍需要固定题库、版本化 Prompt、人工评分标准和独立评测。
我在这项工作中的职责边界
这项案例聚焦的不是训练基础模型,而是把模型能力收进一个可编辑、可恢复、可验证的教学产品:定义结构化合同,建立教师确认点,拆分内容与渲染职责,为精确能力设计确定性路径,并把降级和局部失败变成用户可理解的状态。
第三方模型、SymPy、ECharts、React 和其他渲染库提供了基础能力;TeachFlow 的工作是决定这些能力何时可以使用、输入从哪里来、结果由谁验证、失败后保留什么,以及什么情况下仍必须交给教师判断。
当前本地证据能够支持工程机制、受控样例和失败边界;不能证明真实教学效果,也不能替代学校生产环境中的模型质量、安全审计、IAM、容量、HA/DR 和长期运行验证。