返回 ResolveAI 项目总览 · 交互图:FAULT · DRILL · ISOLATION
为了证明系统能应对 Provider 异常、知识库中断、重复 Tool 请求和配置部分写入,我给 ResolveAI 增加了一组故障演练。
但故障演练同时制造了一个新风险:如果演练生成的失败进入真实质量基线,Resolution Rate、Case 数量和失败模式都会被测试数据污染;如果演练脚本只是打印“passed”,却没有真正执行目标断言,团队又会得到一份比没有报告更危险的假证据。
一次演练复验暴露了脚本的结果判定问题:脚本中的五个步骤有四个真正执行通过,一个因为测试名称已经变化而整文件跳过,但脚本仍把它记成 passed,并最终输出 status: passed。
隔离机制已有代码和测试支持,但演练结果判定仍存在未修复缺口。需要分别检查隔离是否生效、目标断言是否执行;退出码 0 不能自动成为有效证据。
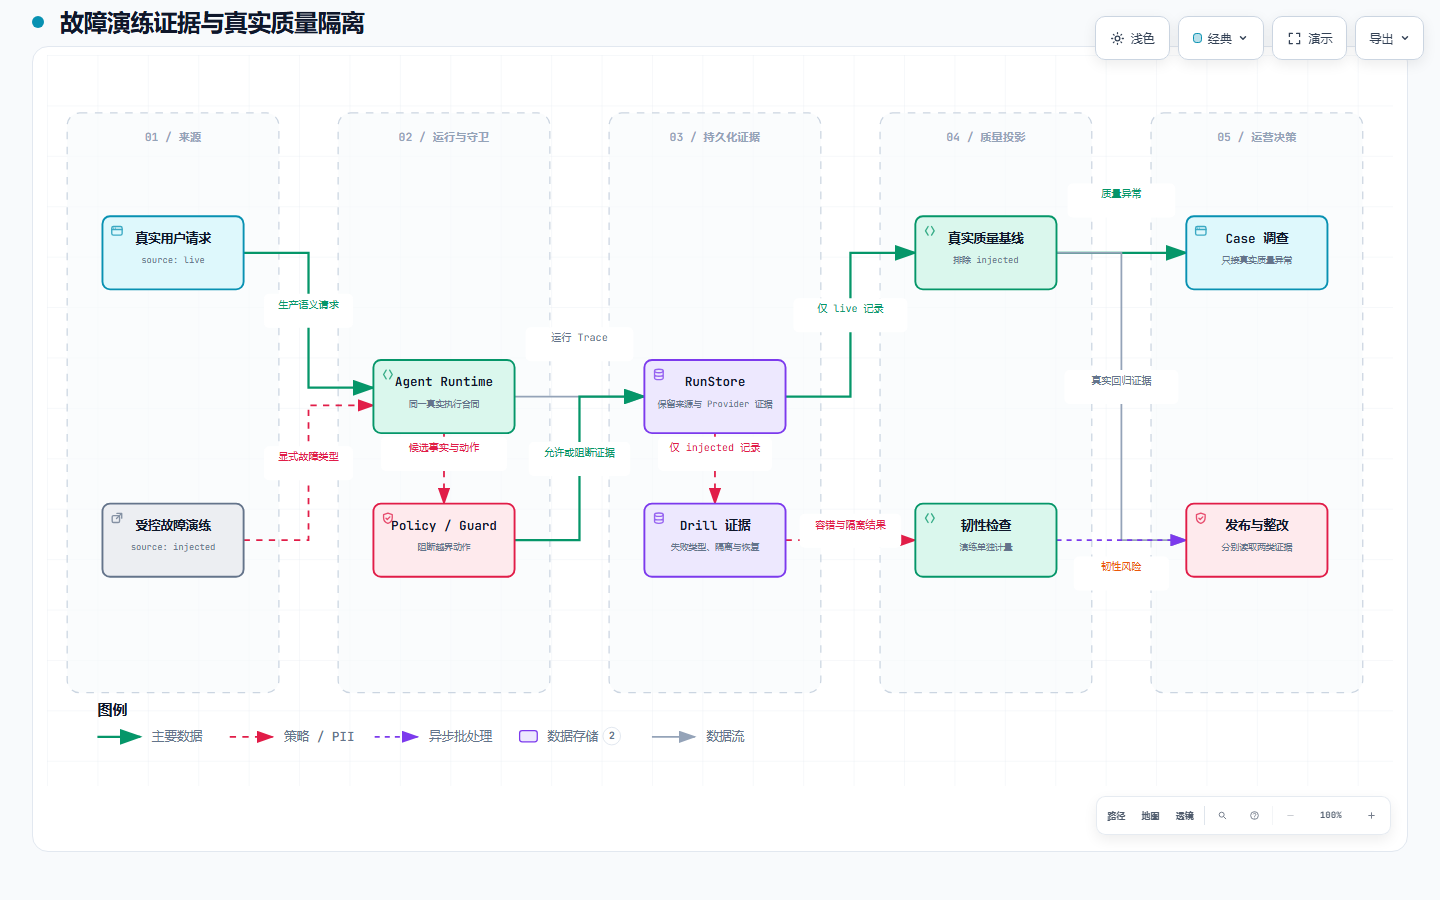
机制图:真实请求和 injected 演练可以复用同一运行合同,但必须在持久化时保留来源,并分别进入真实质量投影和韧性证据投影。
为什么演练不能只写成一个 Mock
如果直接构造一份“Provider 超时”的 JSON,再把它显示在页面上,演示当然稳定,但它没有经过真实的运行控制流。这样的 Mock 无法回答:
- Provider 输出格式错误时,生产解析器是否真的失败;
- 模型不可用时,事实来源是否切换到确定性回退;
- Guard 是否仍然拥有执行权;
- 失败 Trace 是否包含 Provider attempt;
- 演练 Run 是否会意外创建客户 Case;
- 发布投影是否会把演练误认为真实生产坏例。
ResolveAI 的 /api/drills 因此复用实际 Run 合同和持久化入口,只是在请求中显式指定故障类型,并把生成的 Run 标记为 source: injected。演练证据仍然可以拥有 Trace、Provider 状态、决策来源和评测结果,但来源字段会一直跟随记录。
这条设计的重点是“真实走过控制流”,不是“假装发生过生产事故”。
第一条隔离线:Injected Run 不创建客户 Case
RunStore 保存记录时会检查来源。只有非 injected Run 才进入服务案例投影;Case 调查的候选过滤也再次排除 injected。
聚焦测试构造了 Provider 返回畸形内容的演练,并断言:
- 请求返回 201,演练 Run 被持久化;
- Run 保留
source: injected和降级状态; - Provider attempt 被记录;
- 决策来源是确定性策略链,而不是伪造模型动作;
serviceCases()仍为空;investigations()仍为空。
这使演练可以被审计,但不会在客服运营页面上制造一个不存在的客户问题。
第二条隔离线:Injected Run 不进入生产扩展集
生产评测扩展集只接收已经人工确认、可重放、带业务真值的真实质量异常。投影函数首先排除 source === 'injected' 的记录,并把原因写成 non_production_source。
这个边界很重要。演练样本可以验证“系统遇到异常时是否安全退化”,却不能证明“真实用户正在遇到这种失败”,也不能用来提高真实坏例覆盖数。
换句话说,演练回答的是韧性问题,生产扩展集回答的是质量问题。两者可以共同影响发布判断,但不能共用一个分母。
第三条隔离线:高风险信息在 Provider 调用前被阻断
另一项演练尝试把评测真值泄漏到运行上下文。系统在调用 Provider 之前检查 Prompt 资产完整性;发现 evaluator_isolation 边界被破坏后,不再请求外部模型,并在 attempt 中记录 prompt_integrity。
这类测试证明的不是模型“不会作弊”,而是应用控制面没有把答案交给模型。模型没有看到的信息,才有资格被称为隔离;仅仅要求模型“不要使用答案”不构成证据。
外部方法给我的启发:演练的目标是发现准备缺口
Google SRE 的 incident response 指南把准备、响应、恢复和缓解视为完整生命周期,并建议通过 disaster role playing 和 incident response exercises 练习响应能力。Anatomy of an Incident
Google SRE Workbook 进一步介绍了受控的 Disaster Recovery Testing 和较小规模的 Wheel of Misfortune,并强调演练之后要记录哪些地方有效、哪些地方不足,再据此修正响应计划。Incident Response
ResolveAI 当前的演练远没有达到生产 DiRT 的规模:它没有真实多团队协同、生产流量、自动回滚、SLO 恢复窗口或值班机制。外部资料在这里不是“我们已经符合 SRE 实践”的背书,而是帮助我校准文章的判断:一次演练的价值不在于获得绿色状态,而在于暴露控制流、证据和响应计划之间的缺口。
重新运行时发现的伪成功
项目提供了 drills:verify 脚本,依次按测试名称运行五个故障场景。脚本只检查子进程退出码:只要退出码为 0,就向结果数组写入 status: passed。
2026-09-02 的实际运行中:
- Provider 畸形响应隔离:目标测试实际执行,1 项通过;
- Policy nonadherence:测试名称未匹配,96 项全部 skipped;
- Tool 重复请求:目标测试实际执行,1 项通过;
- 配置部分写入恢复:目标测试实际执行,1 项通过;
- 远程知识中断:目标测试实际执行,1 项通过。
第二步虽然没有执行断言,Vitest 仍以 0 退出;脚本于是把它追加成 passed,最终打印五项全部通过。
最小反例非常清楚:
Test Files  1 skipped (1)
Tests       96 skipped (96)
process exit code = 0
script result = passed
被破坏的约束不是“命令必须退出 0”,而是“每个演练必须精确执行至少一个目标测试,并且目标断言通过”。脚本只验证了前半句,没有验证测试执行数量。
为什么相邻测试通过仍不能补齐这条证据
仓库里确实存在一个当前名称为 contains an action-bearing model response at the strict fact boundary 的测试,它使用 policy_nonadherence 演练请求,验证严格事实边界、确定性回退以及 injected 数据不创建 Case。单独运行该测试,1 项实际通过。
但这不能自动证明脚本中描述的“模型 Policy nonadherence 被归因并由 Guard 控制”完整成立。当前测试断言显示的是 Provider 未被调用、modelAdherence: null、guardEnforcement: not_required;它与脚本中更强的自然语言描述并不完全相同。
因此正确结论是:严格事实边界和 Case 隔离有相邻聚焦测试支持;演练汇总脚本对这一步的名称和声明已经漂移,当前总报告不能作为五项全部执行的证据。
根因位于验证合同,而不是业务实现
这次问题没有破坏 RunStore 的 injected 隔离,也没有证明 Guard 本身出错。最早变假的层是演练运行器的验收合同:
- 脚本把人类可读测试标题当成稳定标识;
- 标题变化后,Vitest 没有匹配目标测试;
- “全部跳过”仍返回 0;
- 脚本只检查退出码;
- 最终报告把未执行写成通过。
耐久修复应当至少让每个子进程返回结构化测试结果,并断言目标测试数等于 1、通过数等于 1、跳过数等于 0;更稳妥的做法是使用稳定的 drill ID 或独立测试文件,而不是依赖完整标题匹配。
运行器目前仍只检查退出码,目标测试被跳过时可能产生错误的通过报告。结构化测试结果校验尚待补齐。
怎样设计不污染质量的演练指标
基于当前实现,指标应该分为两组。
真实质量指标只读取 source: live 或其他明确生产来源,用于统计客户问题、Case、失败模式、业务 Outcome 和生产扩展集。
演练指标只读取 source: injected,用于回答:故障是否被触发、是否安全退化、是否产生完整证据、是否创建了不该创建的业务对象、恢复或幂等路径是否有效。
一个发布决策可以同时要求“真实质量门禁通过”和“关键韧性演练通过”,但必须分别展示两组结果。否则,演练次数会改变真实质量分母,真实失败也可能被“这是测试”掩盖。
当前证据状态
可以确认的部分包括:
- injected 来源在 RunStore 中被保留;
- injected Run 不创建服务 Case;
- injected Run 不进入生产扩展集;
- Provider 畸形输出、Tool 幂等、配置部分写入恢复和知识中断四个目标演练实际执行通过;
policy_nonadherence的相邻严格事实边界测试单独执行通过;- 三种演练相关机制图通过 9 项结构检查和四个桌面视口的明暗主题 containment 检查。
不能确认的部分包括:
drills:verify的五项汇总全部有效;- 脚本所描述的 Policy nonadherence 归因与 Guard containment 已由对应目标断言验证;
- 生产级灾难恢复、真实外部 Provider、真实 Tool、远程知识服务或组织响应流程已经演练。
读者可能关心的边界问题
既然脚本有假绿,为什么还展示它?
这个例子暴露了两个不同的检查对象:业务机制,以及演练运行器。相邻测试可以支持业务机制,但总报告仍需确认指定断言确实执行。
为什么不把 injected Run 完全丢弃?
丢弃会失去故障触发、回退、Guard 和持久化路径的证据。正确做法是保留来源并隔离投影,而不是在“污染质量”和“没有证据”之间二选一。
怎样修复演练脚本?
不再仅凭退出码。读取机器可解析的测试报告,要求目标测试实际执行且唯一通过;同时使用稳定 drill ID 或独立测试入口,避免标题变化造成静默跳过。
这些演练能证明生产韧性吗?
不能。当前脚本明确不调用真实 Provider、Tool 或 Bailian,证明的是本地控制流和失败语义。生产韧性还需要隔离环境、真实依赖故障、SLO 恢复窗口和组织响应演练。
结语
故障演练需要同时满足两条看似相反的要求:它必须足够真实,能够穿过实际控制流;又必须足够清晰地标注来源,不能冒充真实用户失败。
ResolveAI 已经通过 source: injected、Case 过滤和生产扩展集排除建立了这条数据边界。但本次复核也证明,证据链的末端仍会出错:一个没有执行断言的测试可以因为退出码为 0,被演练脚本写成通过。
下一步应先修正演练运行器,再重新执行受影响的目标测试。验收条件需要同时检查退出码、实际执行数、通过数和跳过数。