返回 ResolveAI 项目总览 · 交互图:CONTROLLED · ATTRIBUTION · 工作流
Agent 的输出发生变化时,最容易得到的解释通常也是最不可靠的解释:刚调过 Temperature,于是把变化归因给参数;刚改过 Prompt,于是把通过率提升归因给提示词;Provider 恰好超时,于是把一次失败归因给模型能力。
这些解释都可能是真的,但“时间上先后发生”不是归因证据。一次 Run 同时受客户表达、业务状态、上下文装配、场景配置、模型参数、Runtime 版本、Provider 响应和外部 Tool 状态影响。只要其中两个变量一起变化,漂亮的前后对比也可能只是混杂。
ResolveAI 是我的个人实践项目。此前的运行证据链解决了“这次到底发生了什么”,可重放评测资产解决了“以后按什么输入和业务真值重新验证”。这篇文章继续追问第三个问题:当两次结果不同时,怎样把差异缩小到一个可审阅的实验轴;当证据不够时,系统又怎样明确拒绝归因?
当前实现选择了三类最常见的实验轴:模型参数、客户表达和 Provider 上下文。同时,它把 Provider 的每次尝试拆成分阶段诊断,避免把传输故障、JSON 截断、Schema 失败和业务语义拒绝混成一个“模型失败”。
普通 A/B 截图为什么不够
设想两次客服 Run:第一次返回 Tool 调用,第二次返回文本回复。我们至少要回答四组问题。
第一,输入是否完全相同?“退款怎么没到”和“退款成功了但银行卡余额没变”在人看来接近,对模型来说并不是同一字符串。
第二,模型看到的结构化上下文是否相同?同一用户消息如果绑定了不同业务状态、问题分析、Tool Schema 或配置修订,结果差异不能只归给参数。
第三,运行链是否相同?Runtime 版本、Provider 状态、结束原因和重试路径都可能改变最终证据。
第四,我们比较的究竟是什么?只比较最终文案,会漏掉 Decision、Tool 参数、业务状态和评测结论的变化;只比较总分,又会看不到最早的分歧层。
因此 ResolveAI 不把实验建模成“两段文本的 diff”,而是两组可配对的完整 Run。
| 实验轴 | Baseline 与 Candidate 唯一允许变化的内容 | 必须保持的共同基线 | 主要观察 |
|---|---|---|---|
| 模型参数 | Temperature、Top P、Max tokens 中至少一项 | 输入、上下文、配置修订、Runtime 版本 | Decision、Tool 参数、业务结果、评测、Provider 状态 |
| 客户表达 | 用户消息 | 静态上下文、配置修订、Runtime 版本、模型参数 | 结构化问题分析,以及后续 Decision 与业务结果 |
| 上下文消融 | 只从 Candidate 的 Provider 上下文移除一个组件 | 输入、配置修订、Runtime 版本、模型参数 | 被删组件是否真的改变上下文,以及各层行为是否变化 |
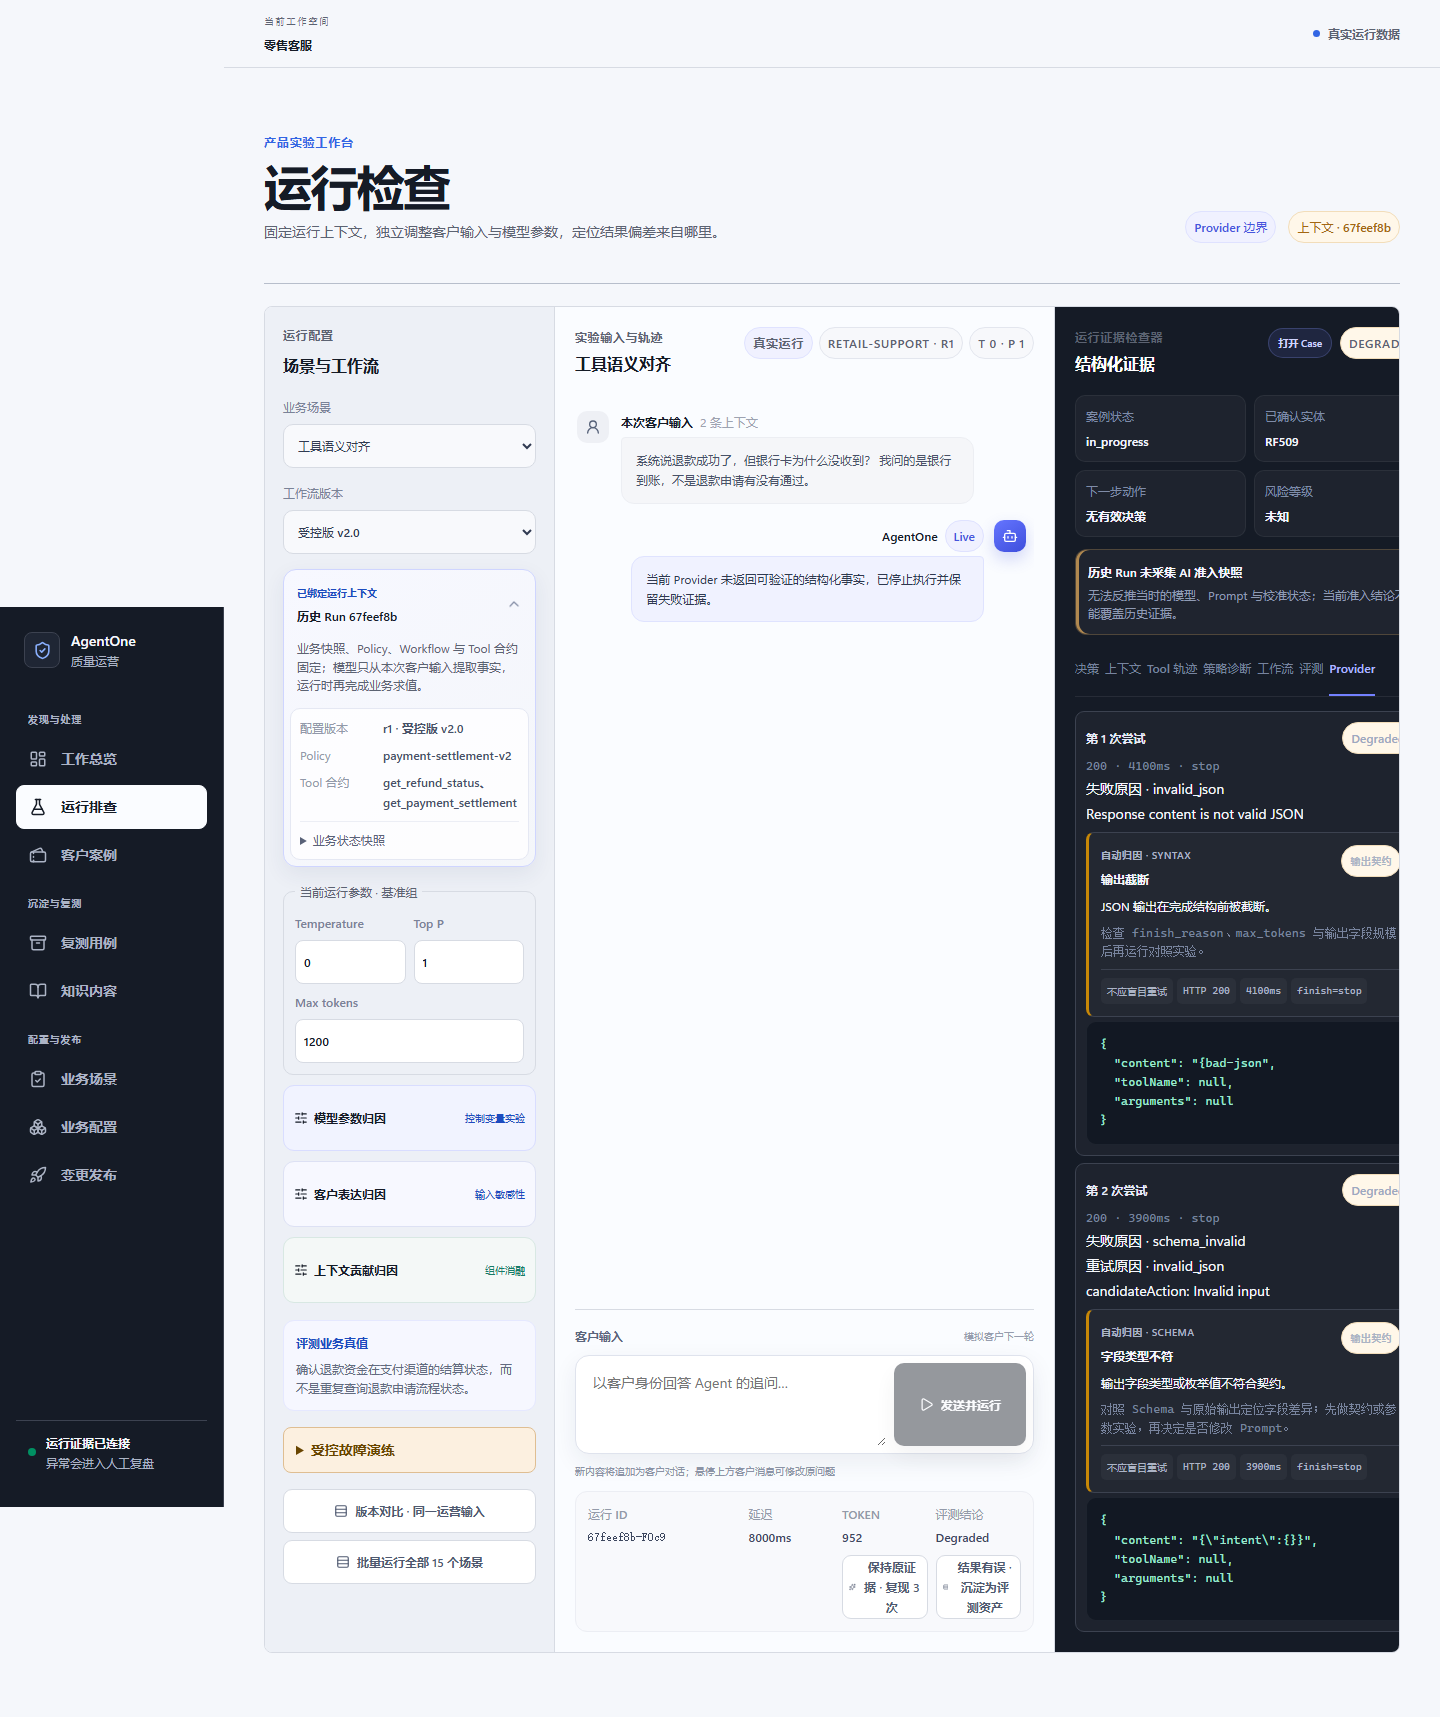
真实产品截图:Playground 把三类控制变量实验和 Provider Attempt 证据放在同一运行工作区。它方便从一个异常 Run 继续追问,但页面上的结果差异仍要经过控制变量检查。
先生成共同指纹,再允许比较
三类 API 都先创建 mode: attribution 的 Evaluation Batch。每轮按 Baseline、Candidate 的顺序各执行一次,repetitions 可选 1、3 或 5,因此请求运行数始终是 repetitions × 2。如果某一侧失败导致两组数量不相等,服务返回“实验不完整”,而不是拿残缺数据计算结论。
参数实验复用同一份消息、初始业务状态、上下文 Run 和业务 Case,只把两组 modelParameters 分别传入 Runtime。客户表达实验复用相同业务状态和模型参数,只替换消息。上下文实验则复用消息与参数,只给 Candidate 增加显式的 ablation treatment。
比较器随后用结构化字段检查共同基线:
- 输入使用 Run 的
inputHash; - 上下文优先使用
contextEvidence.snapshotHash,客户表达实验另用staticSnapshotHash排除消息本身; - 配置使用
tenantId + revision; - Runtime 使用 Run 版本;
- 模型参数使用稳定序列化后的完整对象。
这些指纹让共同基线可以被自动检查。只要任一控制项不同,结论就进入 confounded / inconclusive,并列出具体漂移项。
模型参数:参数走请求字段,不走 Prompt 暗线
当前参数合同只有三个字段:temperature、topP 和 maxTokens。Baseline 与 Candidate 至少要有一项不同,否则实验是 invalid。
服务测试记录了实际发送给 Provider 的请求体:Baseline 的 Temperature 为 0,Candidate 为 0.7;同时检查两组 Prompt 消息中没有出现 modelParameters 字样,且上下文快照哈希相同。这个细节很重要:如果系统一边改请求参数,一边把“当前温度是 0.7”写进 Prompt,那么我们实际改变了两个轴,无法再把差异干净地解释为采样参数敏感性。
比较不止看回复文本。它分别计算 Candidate Action、Tool arguments、业务 outcome、Evaluation verdict 和 Provider status 是否改变,也统计两组通过率与 Decision 稳定度。
若共同基线成立且至少一个观察字段改变,结果是 isolated / parameter_sensitive。但单次配对的公共表述仍然是“当前样本中的参数敏感性线索”,不是“Temperature 导致模型整体质量下降”。若没有观察到变化,结论是 stable_on_sample,并明确写出:这不等于证明参数在总体上无影响。
客户表达:允许分析变化,但业务结果保持稳健
现实客户不会用同一种措辞描述同一个问题。ResolveAI 的客户表达实验固定静态上下文、配置、Runtime 和模型参数,只改变 Baseline 与 Candidate 的消息。
这里有两种都值得区分的结果。
一种是结构化问题分析发生变化,但最终 Decision、Tool 参数、业务 outcome 和评测结论保持一致。系统把它标为 robust_on_sample:中间理解对措辞敏感,但当前样本的业务结果仍然稳健。
另一种是表达变化继续传导到 Decision、Tool 参数、业务结果、评测或 Provider 状态。此时结论是 input_sensitive,并根据问题分析是否先改变,把可能层定位为 problem_analysis 或 model_decision。
这个区分比“两个回复字面不同”更有用。客服回复的措辞本来就可能变化;真正需要优先处理的是表达差异是否改变事实识别、可执行动作和业务状态。
但一对同义表达仍不足以证明系统对真实客户语言稳健。它只提供一个可复查反例。要形成总体结论,还需要代表性表达集、分层抽样、重复运行和清晰的业务判定合同。
上下文消融:删除了什么,必须真的产生差异
上下文贡献不能靠“感觉这个字段有用”来判断。当前实验允许从 Candidate 的 Provider 上下文中移除 problem_analysis 或 business_state,同时保留 Runtime 外部的 Policy 与 Guard 执行链。
一个有效消融必须同时满足两项条件:Candidate 的 contextEvidence.treatment 明确记录目标组件被移除;Baseline 与 Candidate 的上下文快照哈希确实不同。仅仅提交了一个“移除组件”的请求,不代表组件原本存在,更不代表 Provider 实际少看了信息。
服务测试恰好保留了这个反例:所选场景的 Provider 输入本来就没有 problem_analysis。虽然 Candidate 带有对应 treatment,两组 Prompt 都没有该字段,contextChanged 为 false,所以结果必须是 invalid / inconclusive。系统没有因为用户点击了“消融”按钮,就伪造一个上下文贡献结论。
有效消融且出现观察差异时,结论是 context_sensitive;没有观察差异时只能说 stable_on_sample。后者也不能直接变成“这个上下文组件可以全局删除”:它可能只对其他场景、其他状态或长尾输入有作用。
Provider Attempt:先确定失败在哪一层
控制变量成立以后,结果仍可能被 Provider 的执行路径影响。ResolveAI 为每次 Attempt 保存模型、HTTP 状态、延迟、finish reason、usage、输出、错误类型、校验错误、重试原因、脱敏请求快照和 request hash。
在此基础上,确定性诊断规则给出七个核心字段:诊断状态、类别、阶段、责任边界、是否可重试、建议动作和证据。它不调用第二个模型来“解释第一个模型”,因此相同 Attempt 证据会得到相同分类。
当前阶段划分为:
transport:超时、网络失败、429、5xx,责任首先在 Provider 运行链;envelope:响应缺少可消费的 choice 或 content;syntax:JSON 无法解析,或因 finish reason、括号不闭合等证据判断为输出截断;schema:缺字段、多字段、类型不匹配或 Tool arguments 不符合契约;semantic:语法与结构有效,但和业务事实或受控动作边界冲突;prompt_boundary:调用 Provider 前就被 Prompt 完整性门禁阻断。
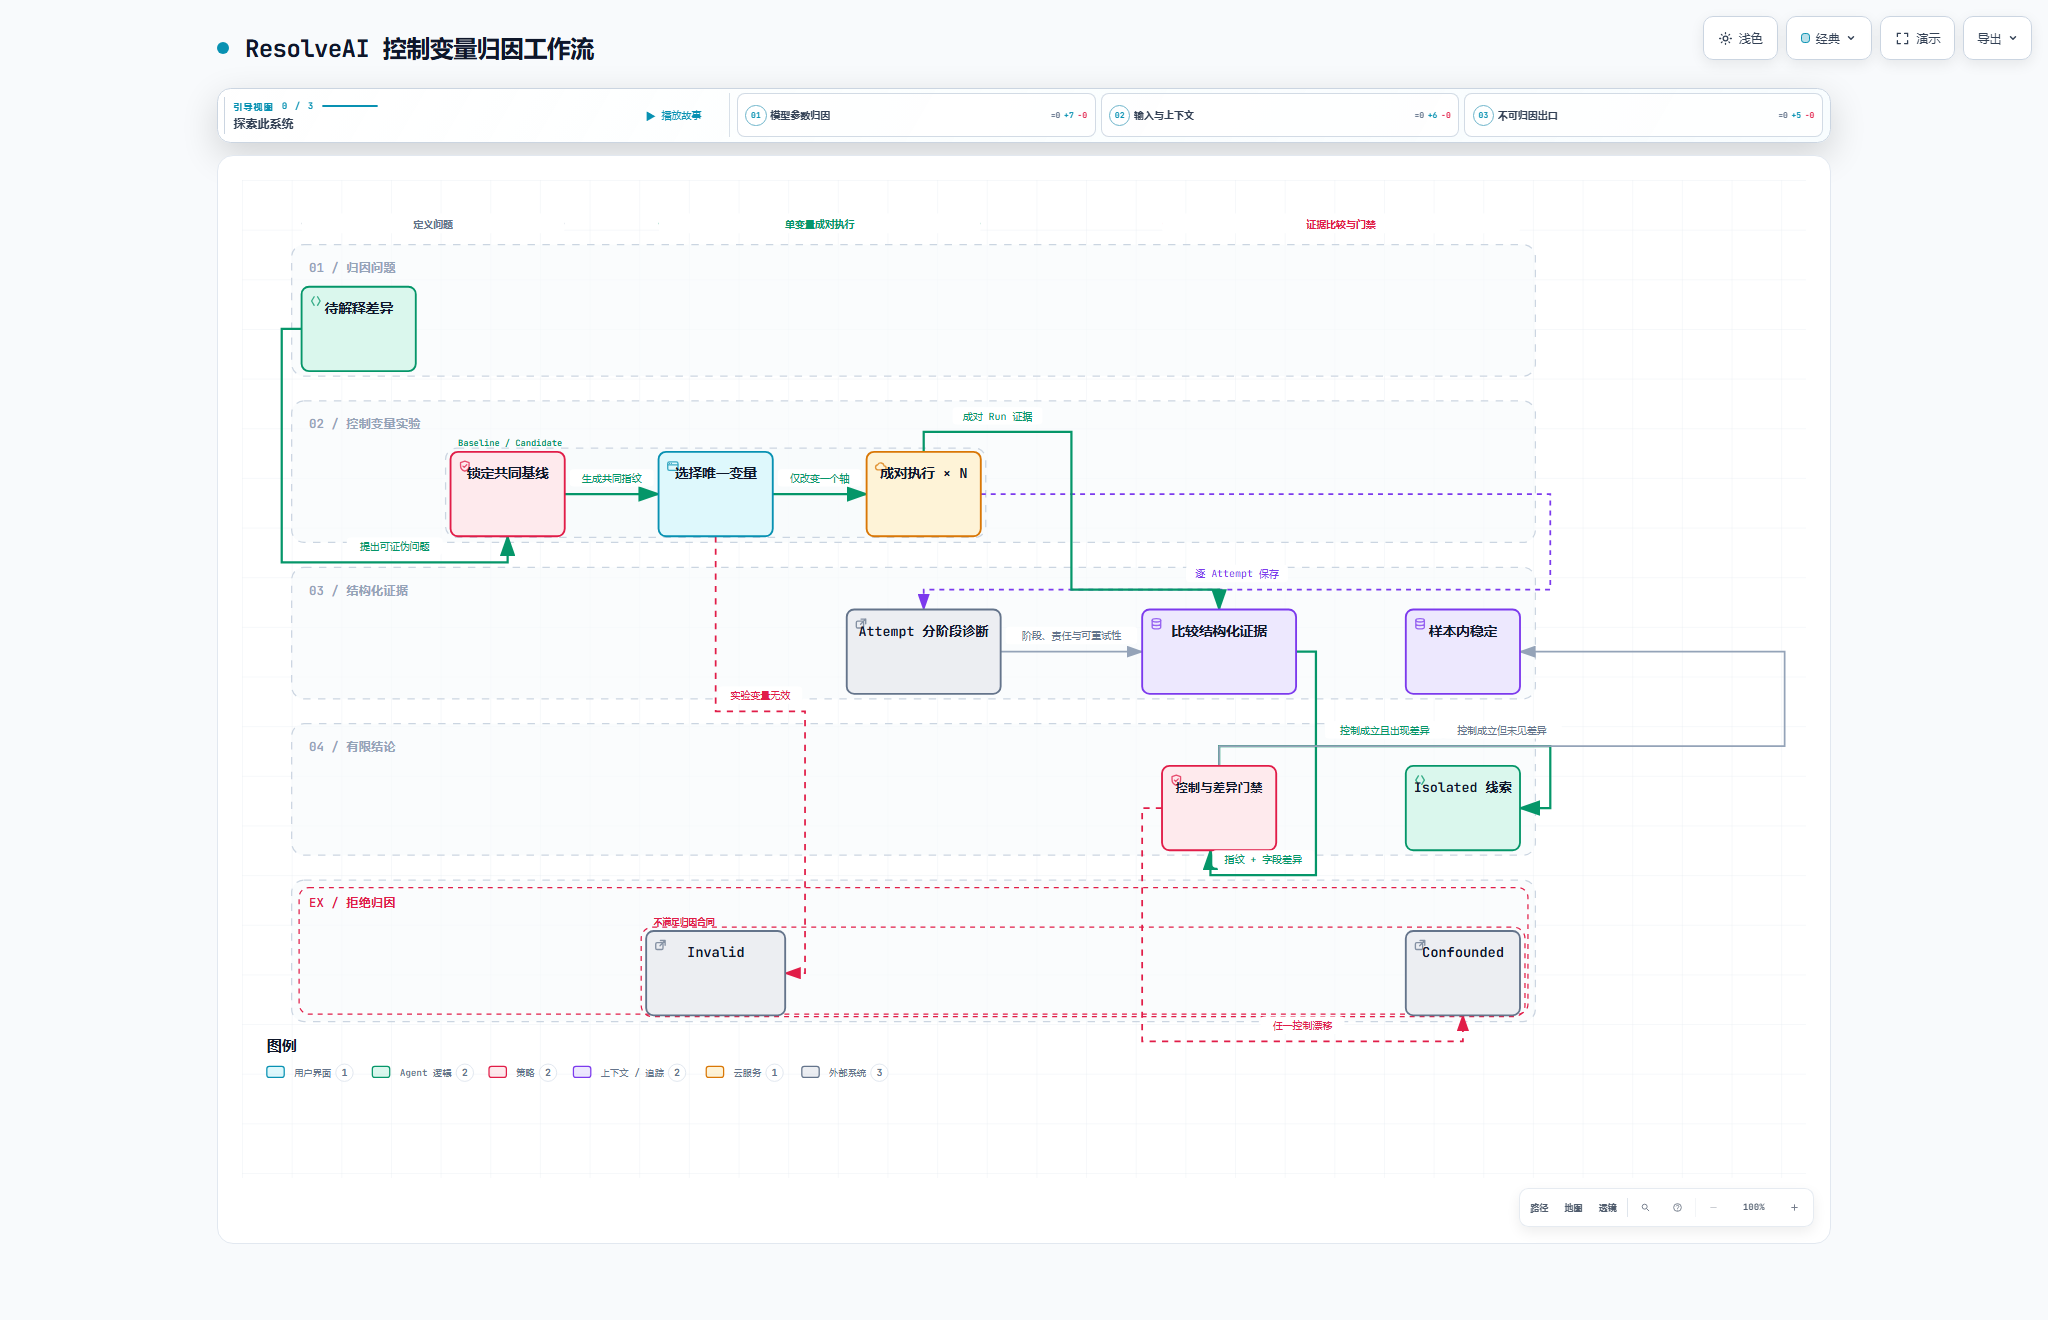
Archify 工作流图:先锁定共同基线并选择唯一实验轴,再把成对 Run、Attempt 诊断和结构化字段送入门禁。实验变量无效进入 Invalid;任一控制漂移进入 Confounded;只有控制成立后,才允许给出样本内稳定或 Isolated 线索。
交互版可以切换明暗主题,并分别聚焦模型参数路径、输入与上下文路径、不可归因出口:/demos/resolve-ai/controlled-runtime-attribution/。
诊断规则也决定 Retry 边界。超时、限流和部分上游错误可以在剩余预算内重试;Schema 错误、Prompt 完整性阻断和语义拒绝不能靠盲目重试解决。Runtime 使用共享的有限重试预算,并保留每次 Attempt,避免 HTTP 层、Provider 适配器和业务层各自重试,最终形成乘法放大。
还要注意:Attempt 的 accepted 只表示 Provider 输出通过当前结构化契约,不代表整个 Run 已经业务成功。后续 Policy、Tool 执行、业务状态转移和 Evaluation 仍可能失败。这里的“通过”必须绑定具体阶段。
四种结论,分别允许说到哪里
| 状态 | 触发条件 | 可以说 | 不能说 |
|---|---|---|---|
invalid | 没有参数差异、输入相同、消融未真正改变上下文,或配对无效 | 本次实验条件不成立 | 变量没有影响 |
confounded | 至少一个共同控制项漂移 | 当前差异不能归给所选轴 | 多个变化中某一个一定是原因 |
isolated + sensitive | 控制成立,当前样本出现结构化行为差异 | 当前样本对该轴敏感;重复配对时证据更强 | 已证明全局因果、质量更高或更低 |
isolated + stable_on_sample | 控制成立,当前样本未见物质差异 | 当前样本内未观察到影响 | 该变量总体无用,可以全局删除 |
isolated 这个词容易被过度解读。这里的含义是:根据当前保存的控制字段,实验只允许一个目标轴变化。它并没有封存 Provider 服务端模型版本、采样随机性、网络、时间和全部外部状态,因此仍然是项目内的归因线索,而不是实验科学意义上的完整因果识别。
重复 3 对或 5 对 Run 会把证据强度从 single_pair 提升为 repeated_pairs,并显示通过率和 Decision 稳定度。它可以发现“只跑一次碰巧相同或不同”的问题,但当前实现没有置信区间、功效分析、随机化、交叉顺序或显著性检验。重复不是统计设计的替代品。
三个最小反例
第一,修改 Temperature 的同时换了一份上下文。即使 Candidate 通过、Baseline 失败,也只能得到 confounded,因为参数和上下文都可能解释差异。
第二,请求移除一个本来不存在的上下文组件。Candidate 有 treatment 标签,却没有实际快照变化,必须得到 invalid。这验证了“操作意图”和“有效实验处理”是两件事。
第三,把 Provider 超时后的 fallback 成功当成模型决策改善。Attempt 证据会显示前一次失败发生在 transport,而不是 Prompt 或业务语义层;如果忽略这条路径,所谓“模型更好”只是运行条件不同。
这些反例说明,可靠归因的关键不是多画几张对比图,而是允许系统拒绝一个听起来很顺的故事。
当前验证与证据边界
聚焦验证执行了 6 个测试文件、128 项测试,覆盖参数比较器、输入与上下文比较器、无效和混杂出口、Provider Attempt 分阶段诊断、有限重试、Playground 三类实验交互,以及服务 API 的真实请求字段、共同哈希和配对执行;全部通过。
测试使用实践数据与测试 Provider,界面截图记录本地状态。本次未执行浏览器端到端验收,也未验证企业身份、多租户隔离及生产运行。若要比较真实模型或 Provider 的质量,还需要代表性数据、受控环境与统计设计。
遇到结果变化时,先选定一个实验轴,检查两次 Run 的共同基线,再沿结构化观察和 Provider Attempt 查找最早差异。如果控制项漂移,先修正实验条件;如果差异来自传输故障,就转向运行链诊断。这样得到的是下一步可调查的位置,而不是仅凭两张截图决定换模型或改 Prompt。