客服 Agent 出现一次错误后,最容易做的事情是把它记进日志,或者直接改一版 Prompt 再跑一次。真正困难的是回答:这到底是系统缺陷还是评测误报?错误首次发生在哪一层?修复后的通过是否只对原样本有效?它为什么有资格进入下一次发布判断?
ResolveAI 把坏例处理成一条有明确入口、人工判断和退出条件的证据链:不可变 Run 固定事实,Case 调查组织证据,人工复核决定去留,版本化数据集保存回归合同,新 Run 验证修复,Release Gate 最终只给出本地质量结论。它不把 AI 诊断当审批,也不把 ready_for_approval 当成已经上线。
本文聚焦这条链路本身。它不讨论如何让模型自动优化,也不宣称这套个人实践项目已经接入企业生产发布平台。
坏例不是一个标签,而是一份可追溯合同
一次失败如果只剩“回答不正确”,几乎无法稳定复现。ResolveAI 的 Run 会固定当时的客户输入、场景与配置修订、Provider Attempt、结构化 Decision、Policy 与 Guard 判断、Tool Observation、Workflow 状态、业务 Outcome、评测结果和 First Point of Divergence。
这些字段刻意分层,因为同一个表面失败可能来自完全不同的位置:模型可能选错业务对象,Policy 可能错误放行,Tool 可能调用失败,也可能 Tool 返回成功但客户目标仍未达成。只有保留分层证据,修复才能落在真正拥有责任的层,而不是所有问题都回到 Prompt。
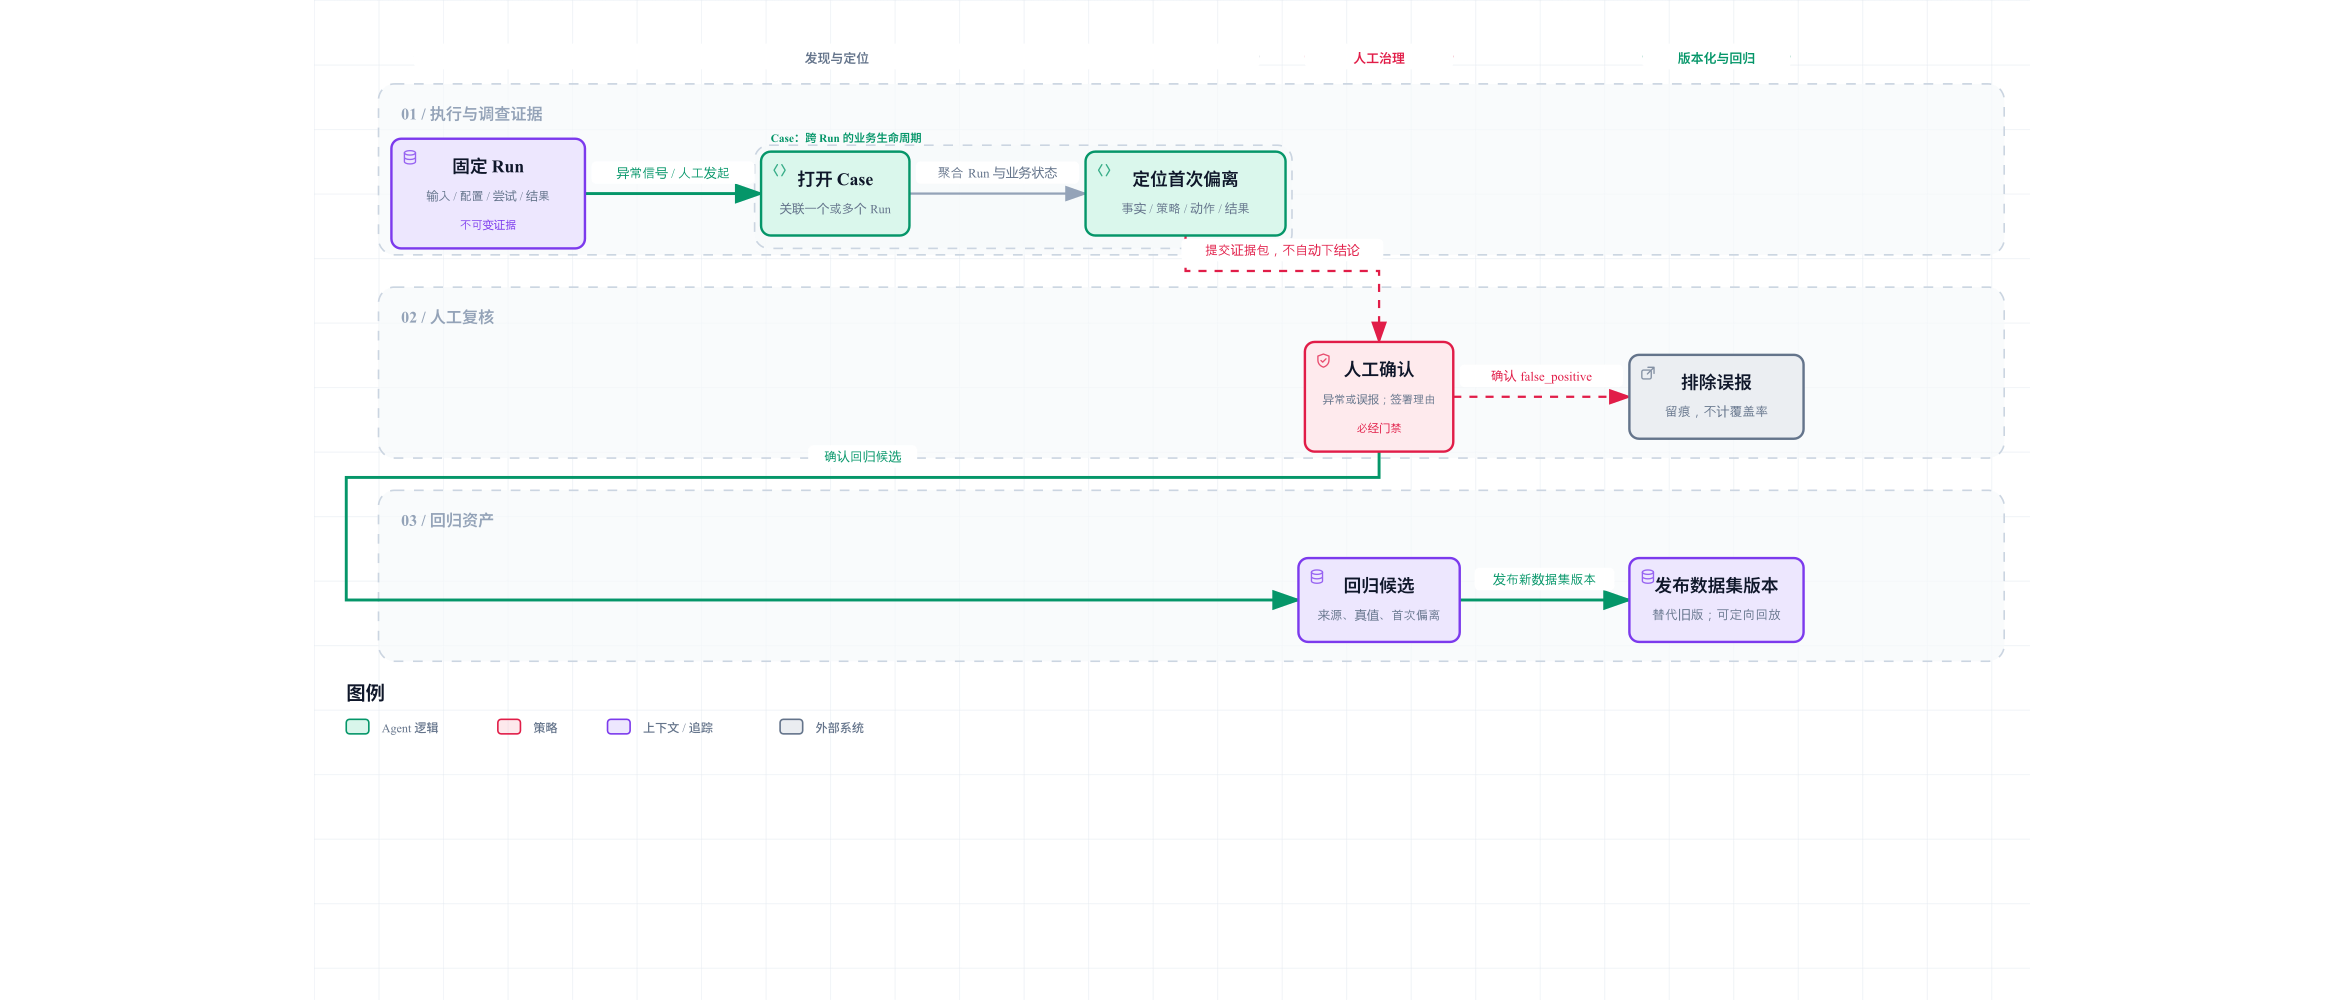
质量闭环的前半段:先固定发生了什么,再由人工决定坏例是否有资格成为回归资产。
第一步:从质量异常自动打开调查
当评测发现失败、降级或 SLA 异常时,RunStore 会为非故障注入的运行建立调查记录,并保存源 Run、业务 Case、场景、配置修订、触发原因、严重度和首次偏离。这里的“自动”只负责创建待处理事实,不负责宣布根因。
Case 与 Run 也不是同一个对象。Run 是一次不可变执行;Case 是一个可能跨多轮、多次运行和人工协同的服务问题。调查记录把两者连接起来,使运营人员既能看到客户问题的上下文,也能回到某次具体执行的原始证据。
为避免调查变成一段不可核验的摘要,项目还构造了三类证据包:
- 业务事实:客户目标、Owner、权威数据源、期望 Outcome 与人工复核;
- 运行归因:输入与请求哈希、模型和 Provider 尝试、配置修订、首次偏离及各层证据覆盖;
- 改进验证:回归候选、数据集版本、发布候选、修复验证和下一步动作。
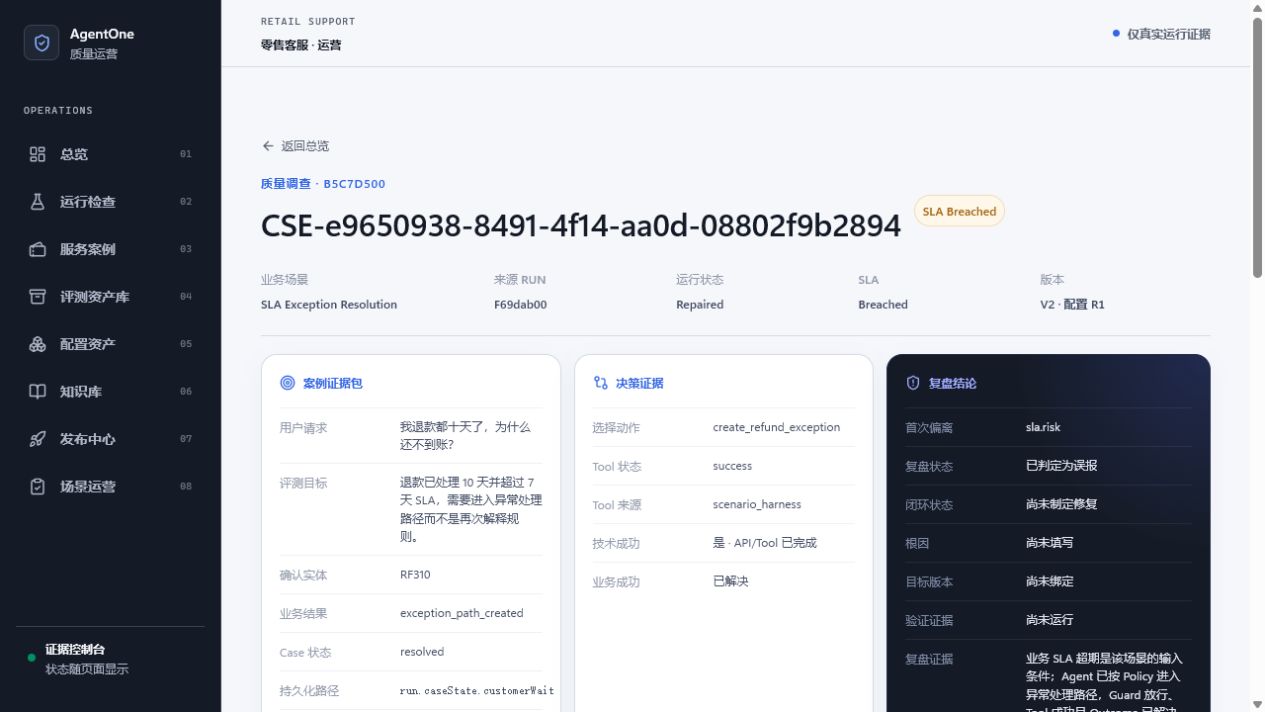
历史演示验收截图:Case 调查并列展示业务事实、运行归因和改进验证。仓库历史截图保留旧界面标识,本文统一使用 ResolveAI。
第二步:AI 可以诊断,人决定它是否是坏例
Case 页面可以调用受校准约束的 AI 诊断,把证据包转换成原因假设和建议的调查方向;系统同时记录本次请求、响应和证据哈希。但这条路径是只读的:它不能替人写入复核结论,不能直接创建回归资产,更不能修改场景配置。
真正改变调查状态的是人工复核。当前合同有两条主要出口:
false_positive:保留审计记录,但调查进入dismissed,不再把这条记录当成改进资产;regression_candidate:调查进入confirmed,并生成一条已批准的回归候选。
一次 Run 的复核不能被第二次提交静默覆盖。这个限制看似保守,却避免了同一历史事实随页面操作反复变色。若结论需要纠正,应形成新的、可解释的治理动作,而不是覆盖原记录。
这里的“人工”也不等于项目中硬编码了某个特定的人。当前实现保存 reviewer、reviewedBy、createdBy 等主体字段,用于证明是谁执行了这次本地操作;默认工作区操作人只是个人实践环境中的占位身份。企业中究竟由 QA Owner、业务 Owner 还是发布经理批准,以及身份如何被 IdP 和 RBAC 证明,仍是待集成的组织边界。
第三步:把结论升级为版本化回归资产
确认坏例后,候选会保存一份可重放合同:原始输入快照、期望 Decision、期望 Outcome 和禁止行为。发布数据集时,系统只接受已批准候选;没有合格候选会直接拒绝,而不是生成一个看起来完整的空版本。
每次发布都会产生新版本。新版本继承既有项目并合入新增候选,前一活跃版本转为归档;候选从 approved 进入 promoted。回归执行绑定明确的数据集 ID 与版本,并使用每个条目保存的原始输入和期望事实,而不是读取后来已经改变的场景默认值。
这和“把原 Case 再跑一次”有本质差别:后者只能说明某个输入在某一刻通过,版本化资产则说明团队保存了什么事实、用哪一版事实评测,以及后续发布判断究竟依赖哪组样本。
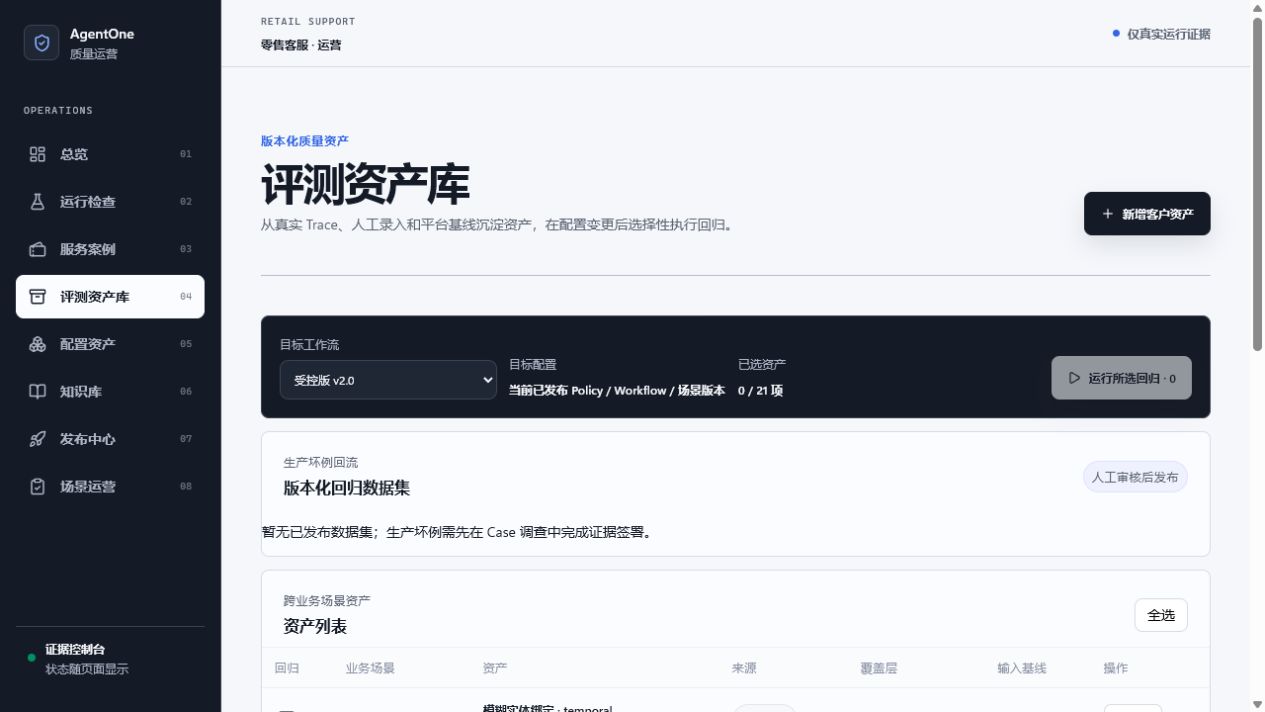
历史演示验收截图:该快照没有已发布数据集,页面因此保留真实空态。它证明界面没有用示例记录伪造资产状态,不证明当前实例已经完成数据集发布。
第四步:修复目标必须固定,验证必须产生新 Run
调查只有在人工确认为真实问题后才能登记 Remediation。修复记录需要指向目标场景修订和变更摘要;开始验证时,服务端会再次检查目标修订是否仍然一致。如果配置已经变化,验证以 target_version_changed 拒绝,防止拿旧结论批准新版本。
验证也不会覆写原始 Run。系统使用原调查中的输入快照创建新的回归批次和新 Run,再把新结果与 Remediation 关联。通过后调查才进入 resolved;失败则继续保持 confirmed。这样,失败事实、修复提案和验证结果分别存在,复盘或审阅时可以回答“原来哪里错、改了什么、用什么新证据证明”。
第五步:发布门禁给结论,但不替组织上线
Release Candidate 会绑定目标配置修订、受影响案例、回归批次、回滚计划和门禁结果。门禁汇总通过、失败、降级、AI 证据一致性以及跨样本泛化状态:任何关键条件不满足,候选进入 blocked;全部满足,状态才成为 ready_for_approval。
这个名字故意没有叫 approved 或 released。它表达的是“本地证据已经足够提交给外部批准流程”,而不是“某位负责人已经批准”,更不是“生产流量已经切换”。
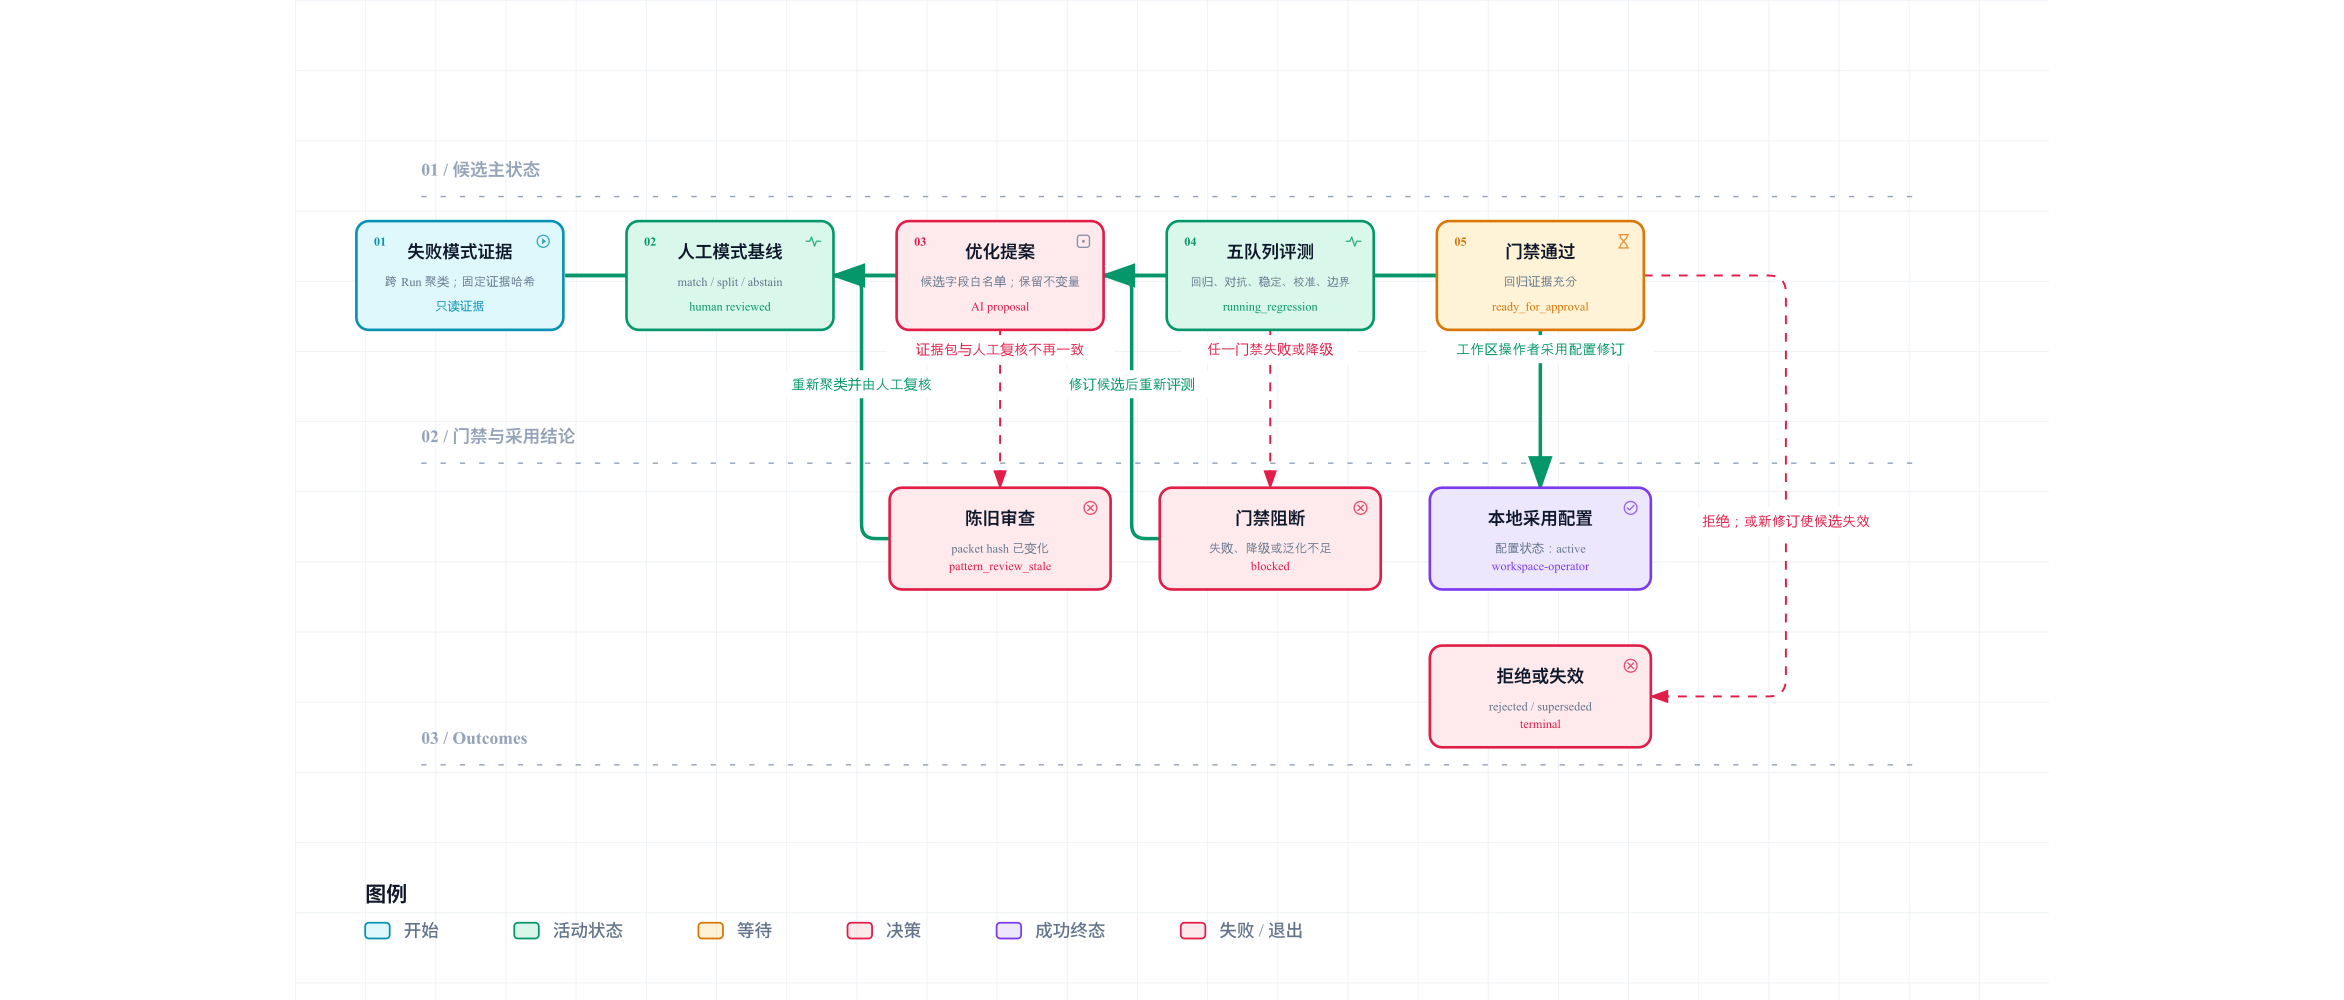
质量闭环的后半段:版本化证据和多组评测形成门禁;过期、失败、拒绝和被取代都有独立出口,通过后仍停在待外部批准。
在当前实现中,新建发布候选的 externalApproval 与 productionRelease 都明确是 waiting_integration。Release Center 可以导出证据包、显示受影响案例与阻断原因,但没有伪造企业审核人、灰度平台或回滚执行结果。
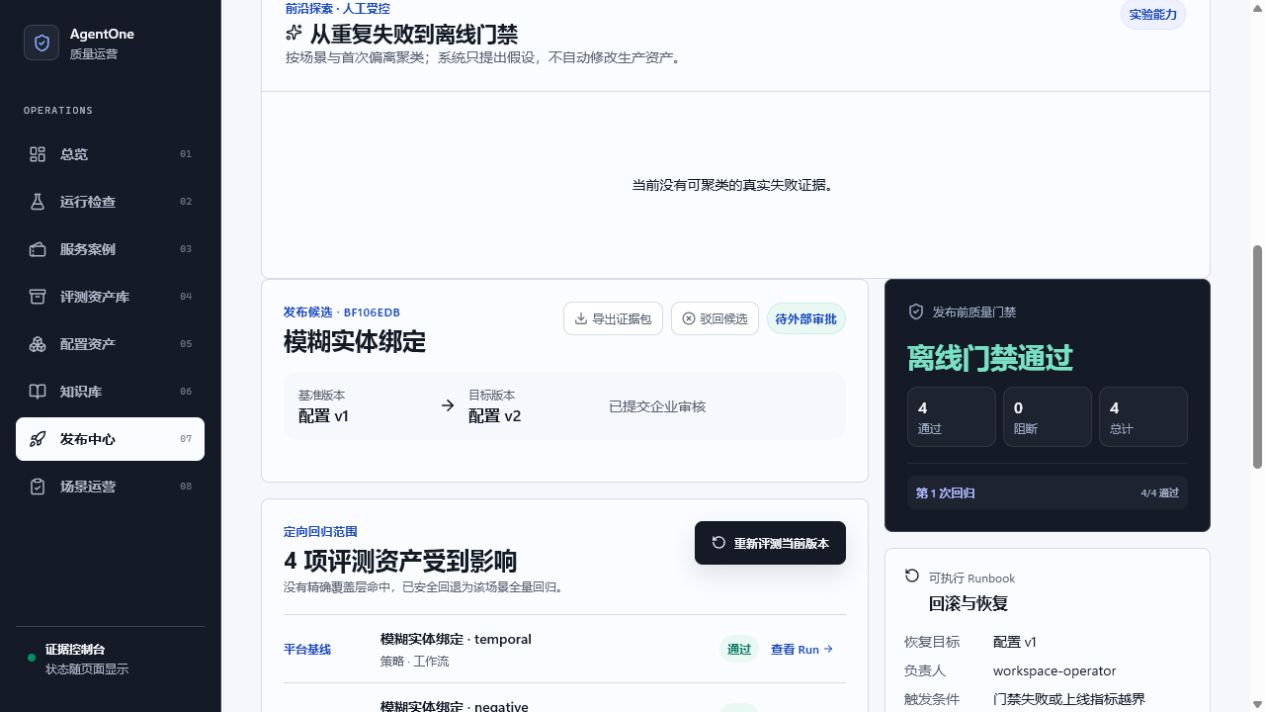
历史演示验收截图:Release Center 把本地质量门禁与待接入的身份审批、生产灰度和回滚执行分开。
“最终审批”到底是干什么的
质量门禁通过后,仍需决定谁有权把这个版本交给真实流量。这个决定涉及业务窗口、合规要求、值班与告警安排,需要由组织审批流程处理。
本地系统保存受测版本、资产、门禁结果和回滚依据,并形成“可提交审批”的状态与主体字段。企业身份系统和实际审批链尚未接入。
如果只在本地演示,运行到 ready_for_approval 就已经完成了本项目负责的发布前质量闭环;如果未来接入真实组织,再由外部 IdP、RBAC、变更单和发布平台决定具体审批人并回写结果。这个边界比硬编码一个“最终审批人”更符合项目现状。
两个容易被忽略的反例
误报不是失败资产。 如果人工确认评测条件或期望事实有误,记录会被保留,但不会进入回归候选。否则,错误的 Oracle 会把正确行为长期锁死。
旧证据不能批准新版本。 修复验证绑定目标修订;版本变化后必须重新验证。发布门禁中的候选也保留被拒绝、被阻断和被新候选取代的状态,避免旧的绿色结果继续为新配置背书。
当前证据状态
本文对应的当前工作树已经通过快速验证门禁:65 个测试文件、450 个测试通过,独立 TypeScript 构建和 Vite 生产构建通过,受跟踪文件密钥扫描与 9 个 JSONL 文件完整性检查通过。
源码和聚焦测试已经确认人工复核、回归候选、数据集版本、修复验证和发布门禁的合同。当前本地实践数据也保留了被确认、误报退出、待批准、被阻断和被取代等状态样本。但在已检查的本地运行记录中,runs.jsonl 没有 regression.dataset.published 事件,因此不能声称这份本地实例已经把现有候选发布为数据集,更不能把不同时间的截图拼成一次完整的端到端运行。
本文使用的页面图片是 2026 年 7 月 31 日的历史演示验收快照,流程图是基于源码合同制作并已人工审阅的解释图。它们用于说明产品界面和机制,不代表真实客户流量、企业采用、生产容量或业务指标。
结语
一个坏例真正有价值,不是因为它让团队多改了一次 Prompt,而是因为它能沿着证据链改变后续发布判断。
ResolveAI 把这条链拆成了可审阅的状态变化:Run 固定事实,调查定位偏离,人工排除误报或批准候选,数据集保存版本化真值,新 Run 验证修复,Release Gate 形成待批准结论。每一步都能回答输入、责任人、版本和退出条件,也都不会越权替下一步宣布成功。
它还没有证明真实生产效果,但已经形成了一个可以继续检验的工程判断:Agent 质量治理不是让系统更快地自我修改,而是让每一次修改都知道自己依据什么、验证了什么,以及还没有被谁批准。